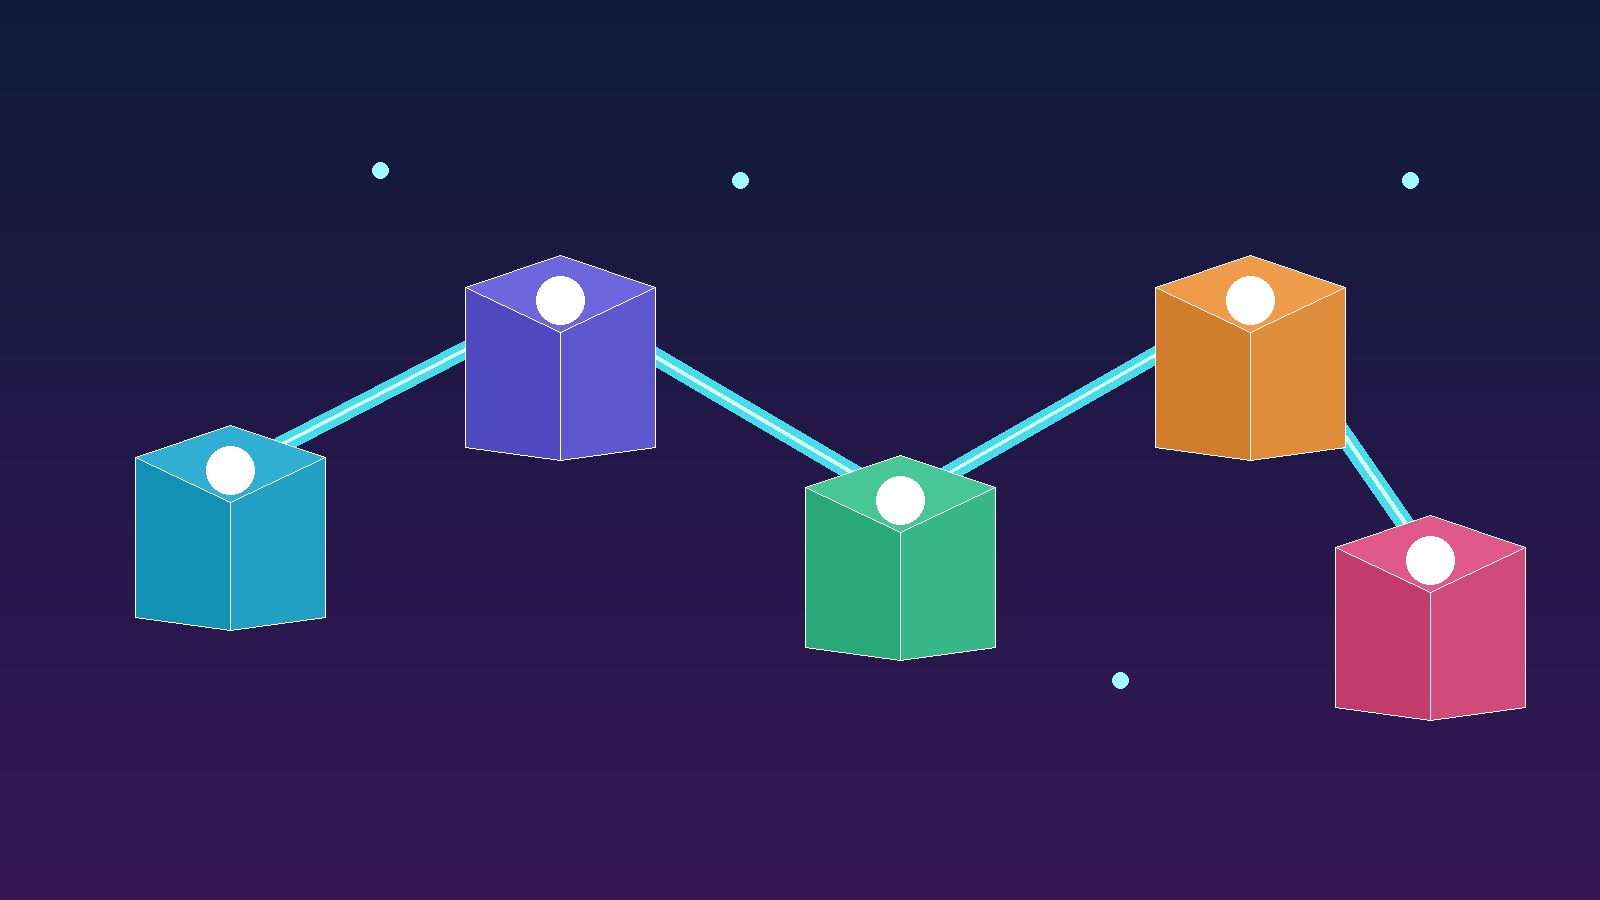
一次请求经过网关、订单服务和库存服务后才返回。日志散落在多台机器上,只看时间戳很难定位慢点。分布式追踪给请求一个可传播的上下文,再把每段工作记录成有父子关系的 Span,最终还原完整路径。
一次请求经过网关、订单服务和库存服务后才返回。日志散落在多台机器上,只看时间戳很难定位慢点。分布式追踪给请求一个可传播的上下文,再把每段工作记录成有父子关系的 Span,最终还原完整路径。
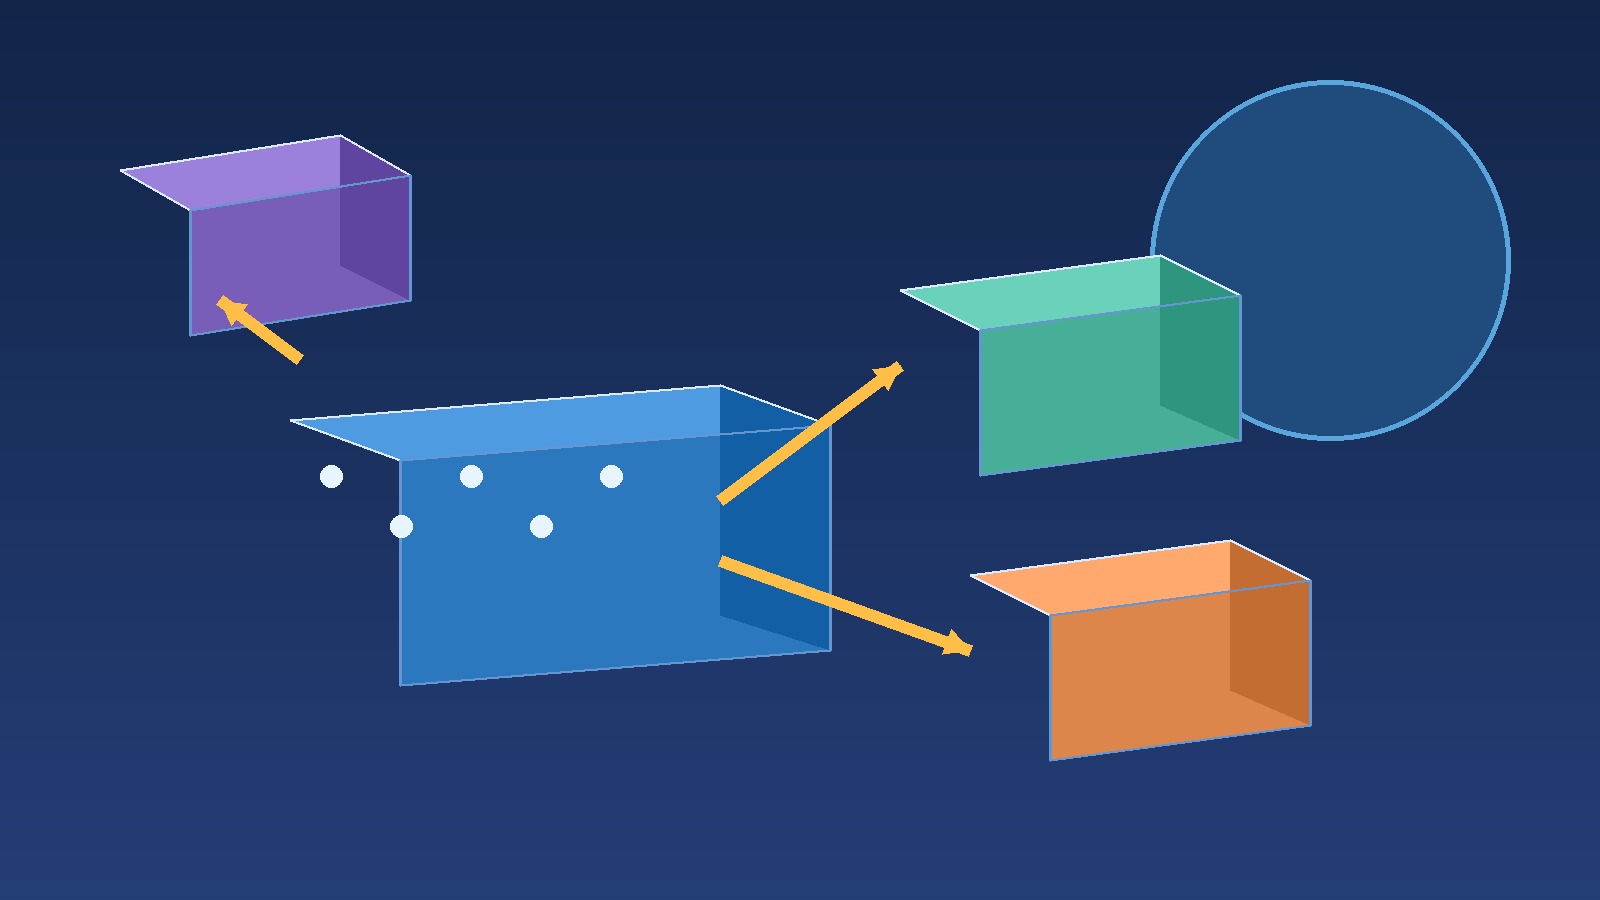
当一个仓库需要复用另一个独立维护的仓库时,Git Submodule(子模块)可以保留清晰的边界:主仓库记录组件仓库的某个提交,而不是把组件源码复制进来。但子模块也很容易变成“目录里有代码、发布时却不是这份代码”的隐形风险。把提交钉住、更新流程和 CI 校验写清楚,才能让它适合长期维护。
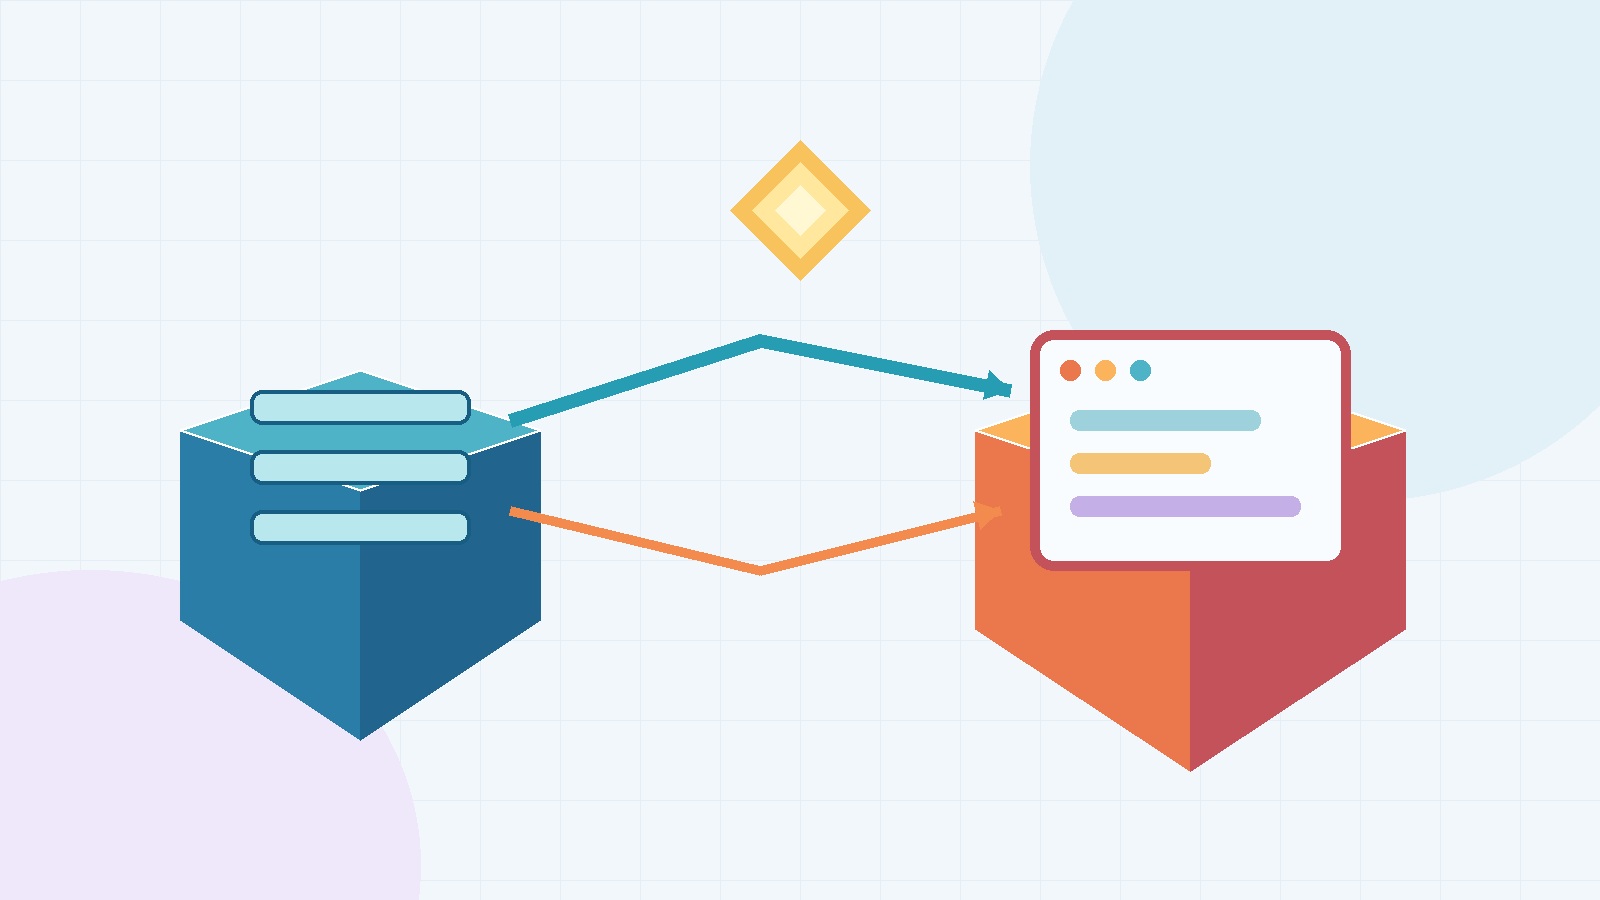
一个页面的 HTML 可能要等数据库查询、模板渲染和权限判断完成后才能返回,但浏览器真正需要的 CSS、字体和脚本往往早已确定。HTTP 103 Early Hints 允许服务器在最终响应之前,先把这些资源提示给浏览器,让网络传输和服务端计算并行发生。
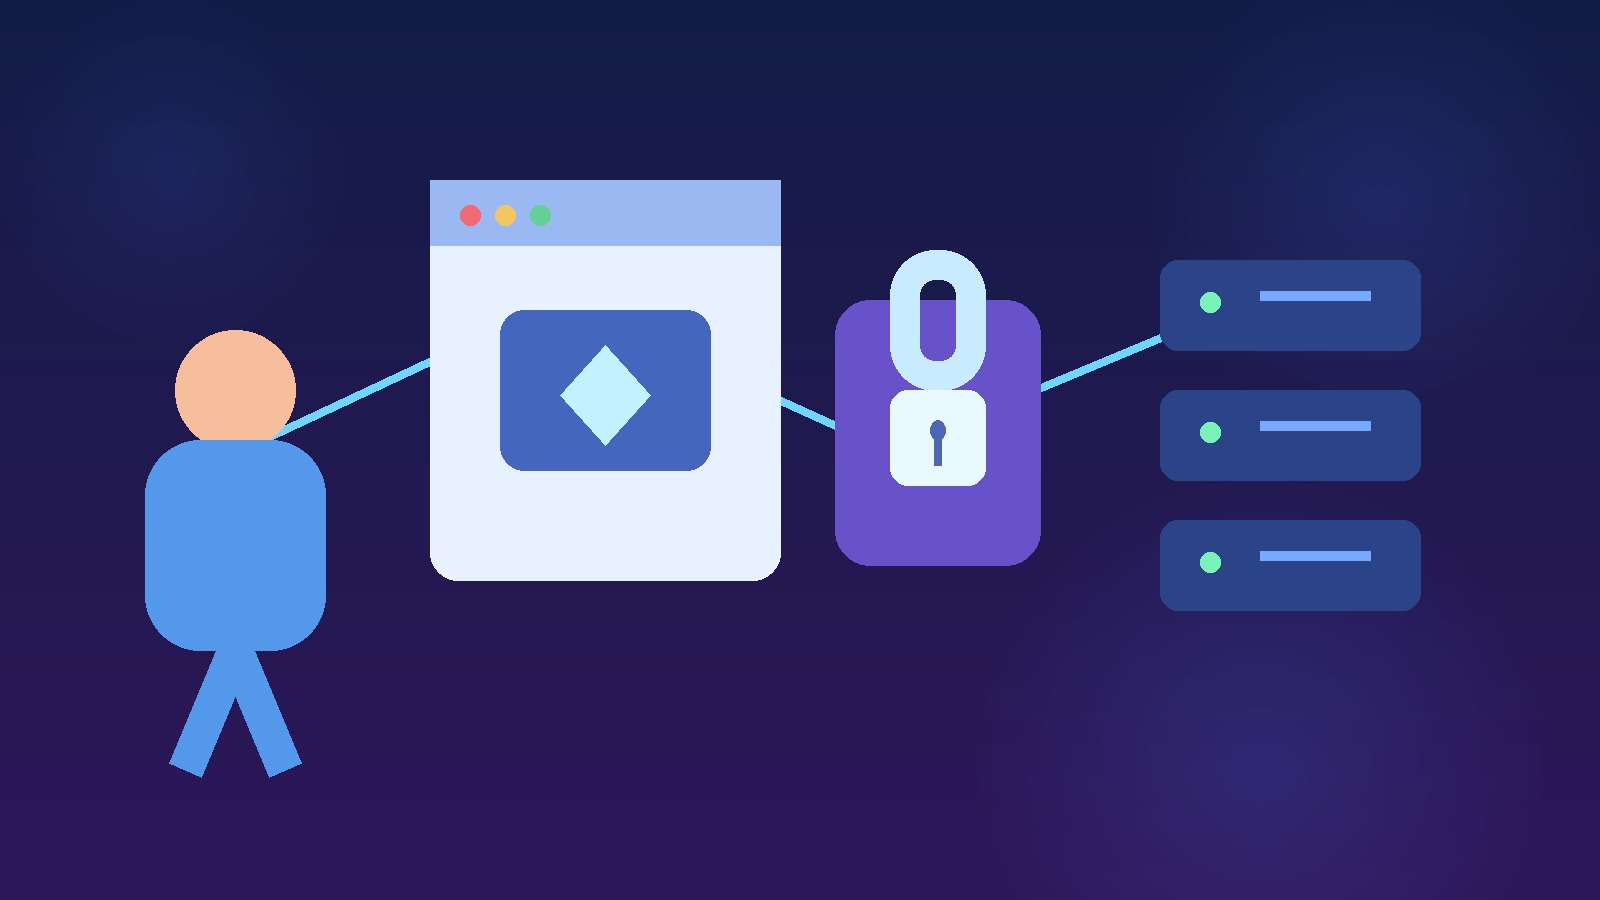
把 JWT 放进 Authorization 头并不等于完成了登录系统。真正难处理的是令牌活多久、刷新时如何轮换、用户退出后怎样失效,以及密钥泄露时如何止损。把这些问题拆成生命周期,才能让“无状态”变成可运维的认证方案。
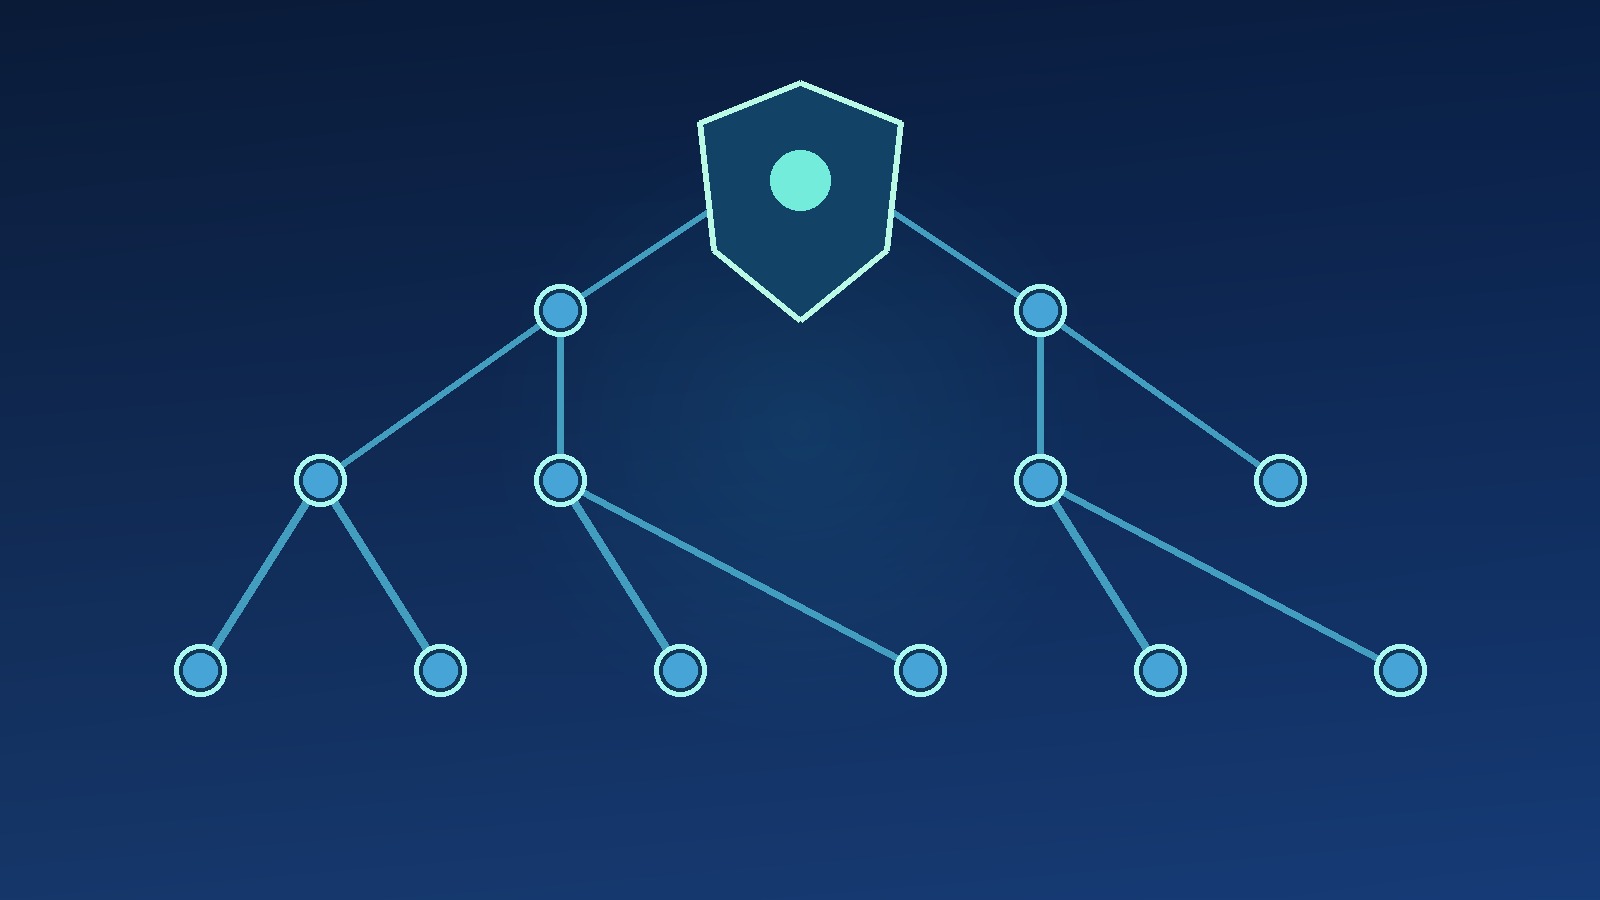
当文件很多、数据来自不可信节点,或客户端只想验证其中一条记录时,逐字节下载并重新计算全部内容既慢又昂贵。Merkle Tree(默克尔树)把大量叶子摘要压缩成一个根哈希,让系统能用短小的证明回答“这条数据属于这份集合吗”,也能快速定位哪一块发生了变化。
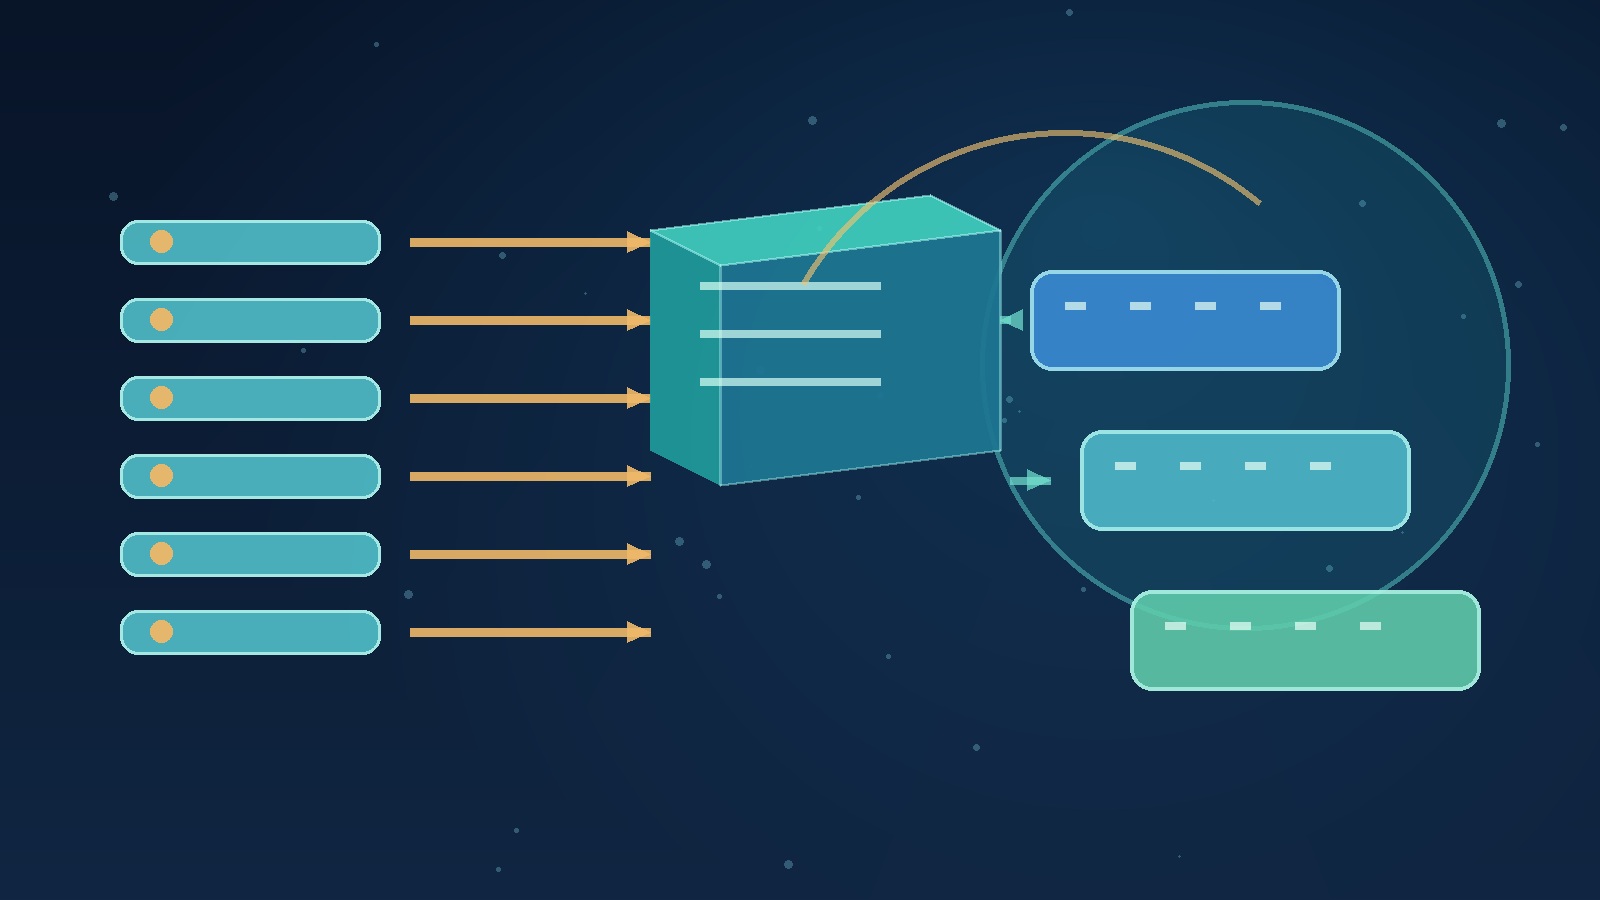
很多键值数据库和写入密集型系统,都把“随机写”改造成“顺序写”。理解这条路径,才能解释为什么写入很快、为什么读放大会突然出现,以及磁盘空间为何会在压缩期间短暂上涨。LSM-Tree 不是一棵需要原地平衡的树,而是一组按阶段生成、再逐步合并的有序文件。

统计一天的请求耗时,均值只能告诉我们整体水平,方差才能反映波动。但日志可能装不进内存,数据也可能持续到来。Welford 算法只保存计数、均值和离差平方和,就能边读边更新统计量,还能避开一种常见的浮点消减问题。
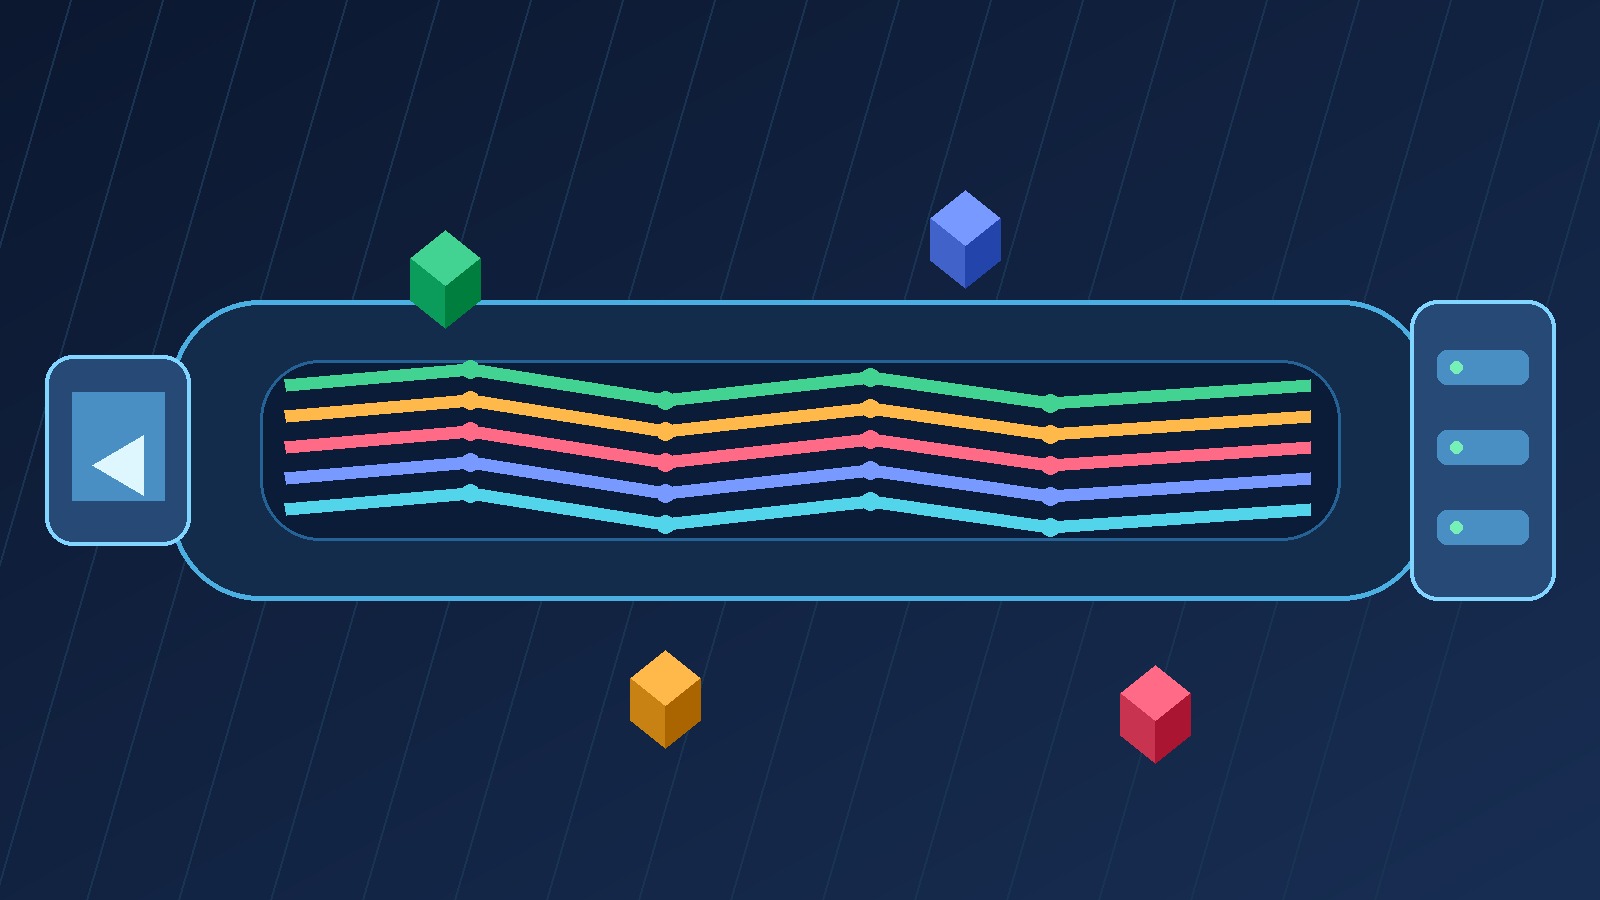
打开一个页面时,浏览器会同时请求 HTML、脚本、样式和图片。HTTP/1.1 通常需要多个连接来减少排队,HTTP/2 则把这些请求拆成可以交错发送的二进制帧,放进一条 TCP 连接。理解“帧、流、窗口”三个层次,才能解释为什么连接数变少了,某些慢请求却仍会拖住页面。

一批设备不断上报互通关系,后台需要反复回答:“这两台设备是否已经连在一起?”每收到一条关系就遍历整张图,容易产生重复工作。若关系只增加,可以用并查集维护分组,把查询变成寻找代表节点,把新连接变成两个集合的合并。