mmap 能让程序像访问内存一样读取大文件,省去显式的 read 与缓冲区搬运,常见于索引、模型和进程间共享数据。但映射只是把一段虚拟地址关联到文件,并没有把文件变成永远有效的数组;忽视长度、并发截断和落盘边界,轻则读到旧数据,重则进程直接收到 SIGBUS。
mmap 能让程序像访问内存一样读取大文件,省去显式的 read 与缓冲区搬运,常见于索引、模型和进程间共享数据。但映射只是把一段虚拟地址关联到文件,并没有把文件变成永远有效的数组;忽视长度、并发截断和落盘边界,轻则读到旧数据,重则进程直接收到 SIGBUS。
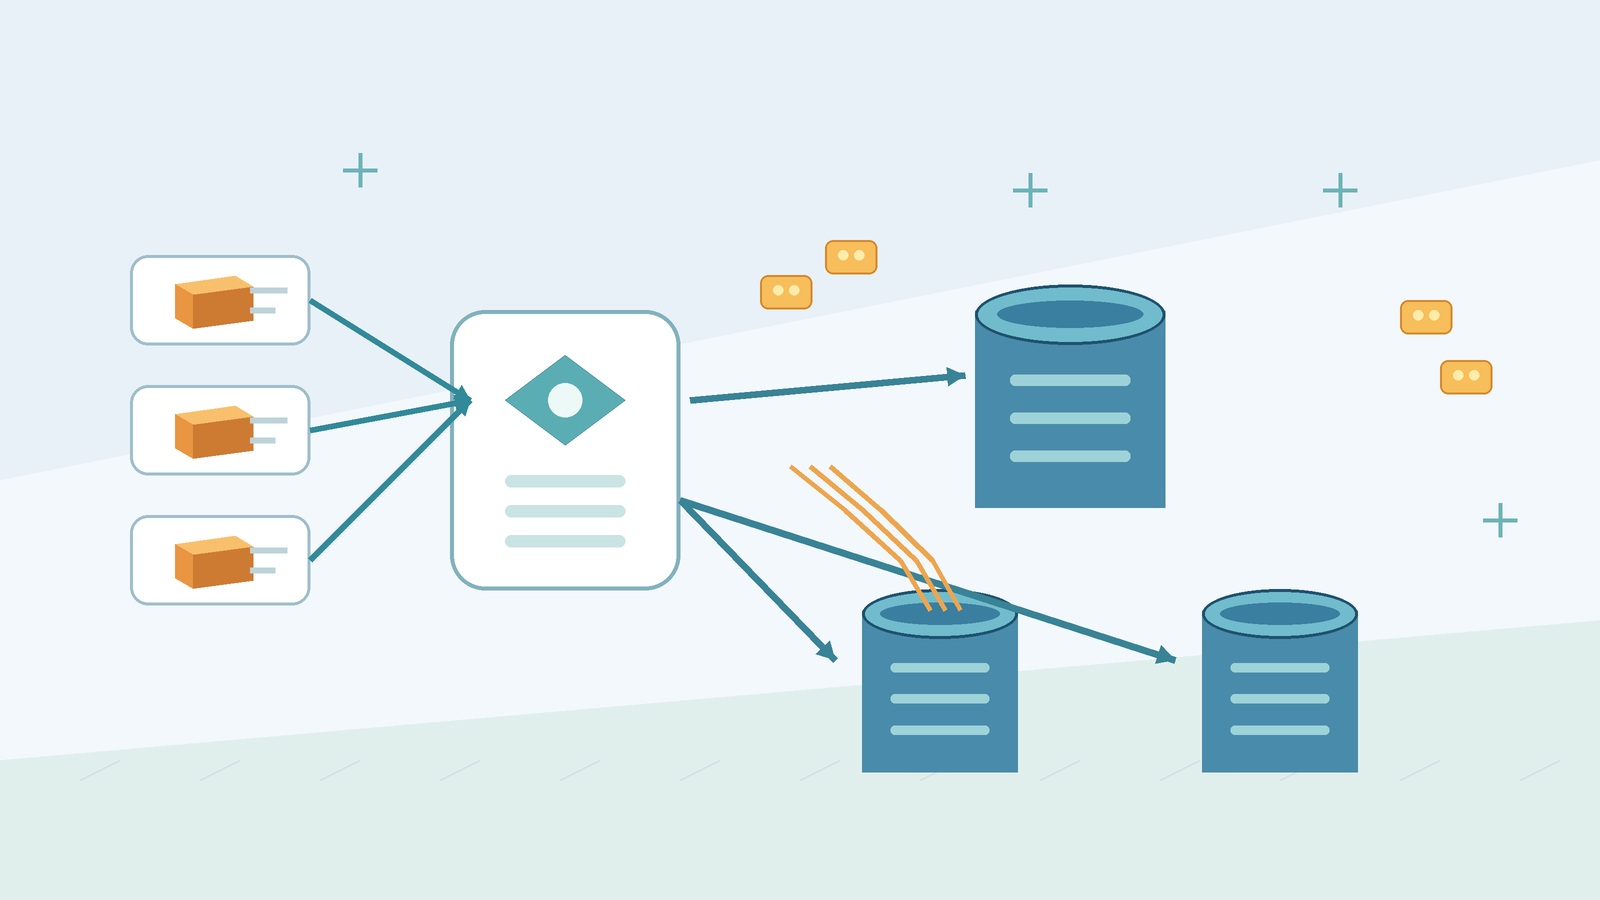
把查询分到只读副本,常常能缓解主库的 CPU 和连接压力,但它也引入了一个新的事实:写入完成,不代表每个副本已经看见这次写入。若路由只按“读走副本、写走主库”两条规则实现,用户就可能刚改完资料,刷新页面却看到旧值。读写分离的难点不是连上几个数据库,而是把复制延迟转换成可解释、可监控的业务策略。
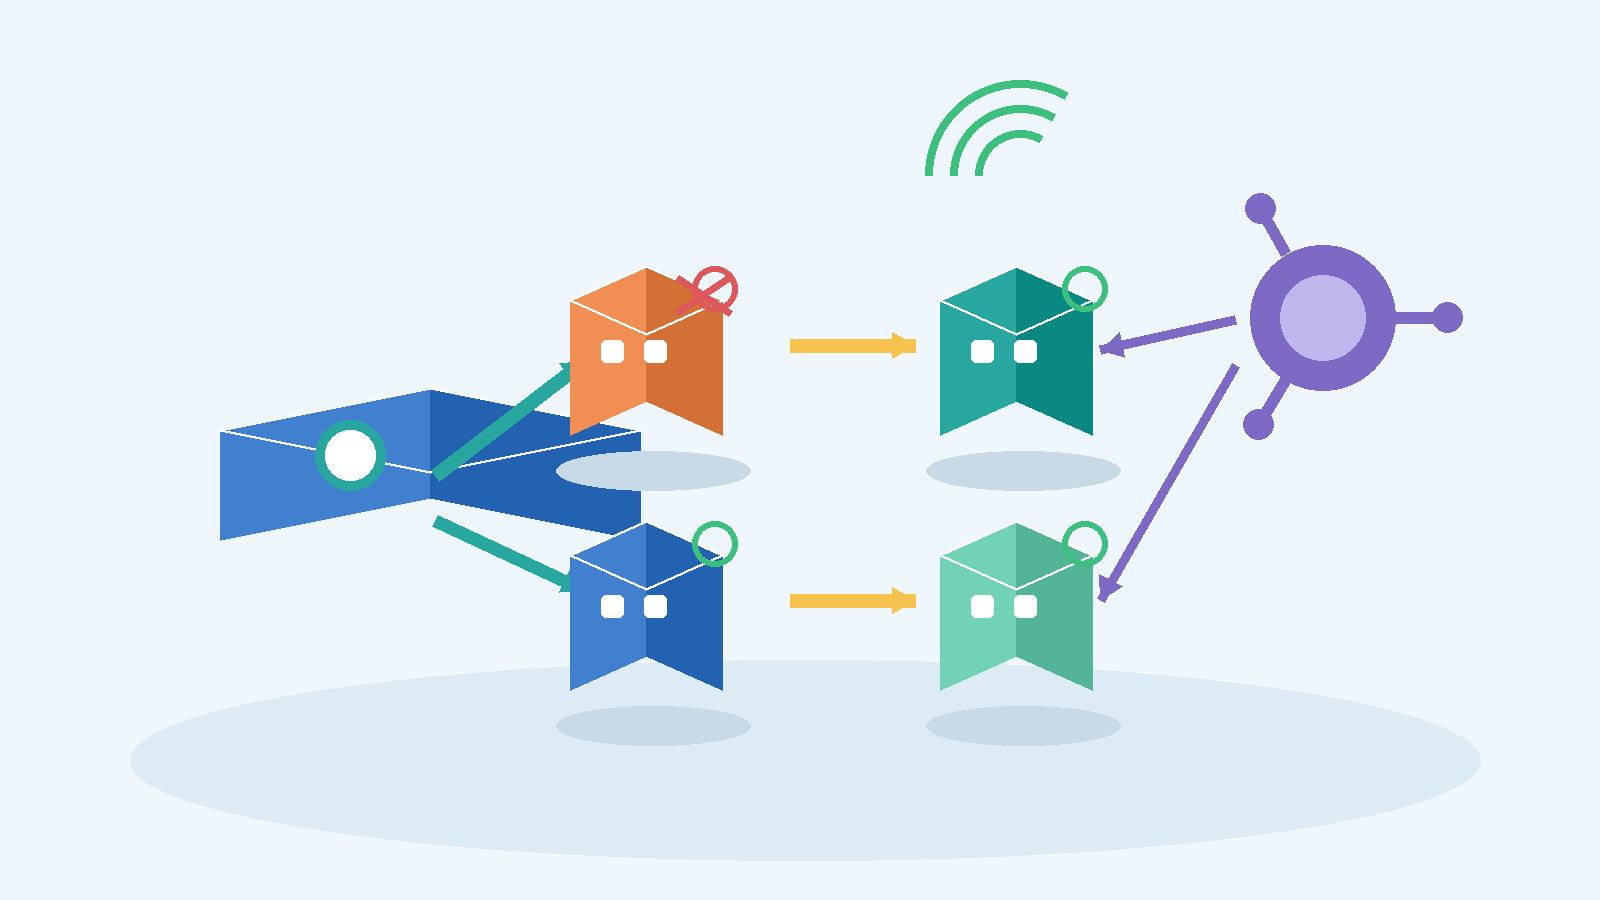
Deployment 更新卡住时,盯着 Pod 日志往往只能看到结果,找不到控制器为什么不再推进。滚动更新其实是一组可计算的约束:新旧 ReplicaSet 如何交替扩缩、最多允许多少副本不可用,以及哪些 Pod 仍属于这个 Deployment。把这些约束拆开,排障就能从“反复重启”变成可验证的检查。
预览窗口已经关闭,内存中的预览对象却一直留着。排查后发现,全局字典为了按名称查找对象,也成了它们的长期持有者。Python 的弱引用可以让登记表保留查找能力,同时把对象何时结束生命交给真正使用它的业务代码。
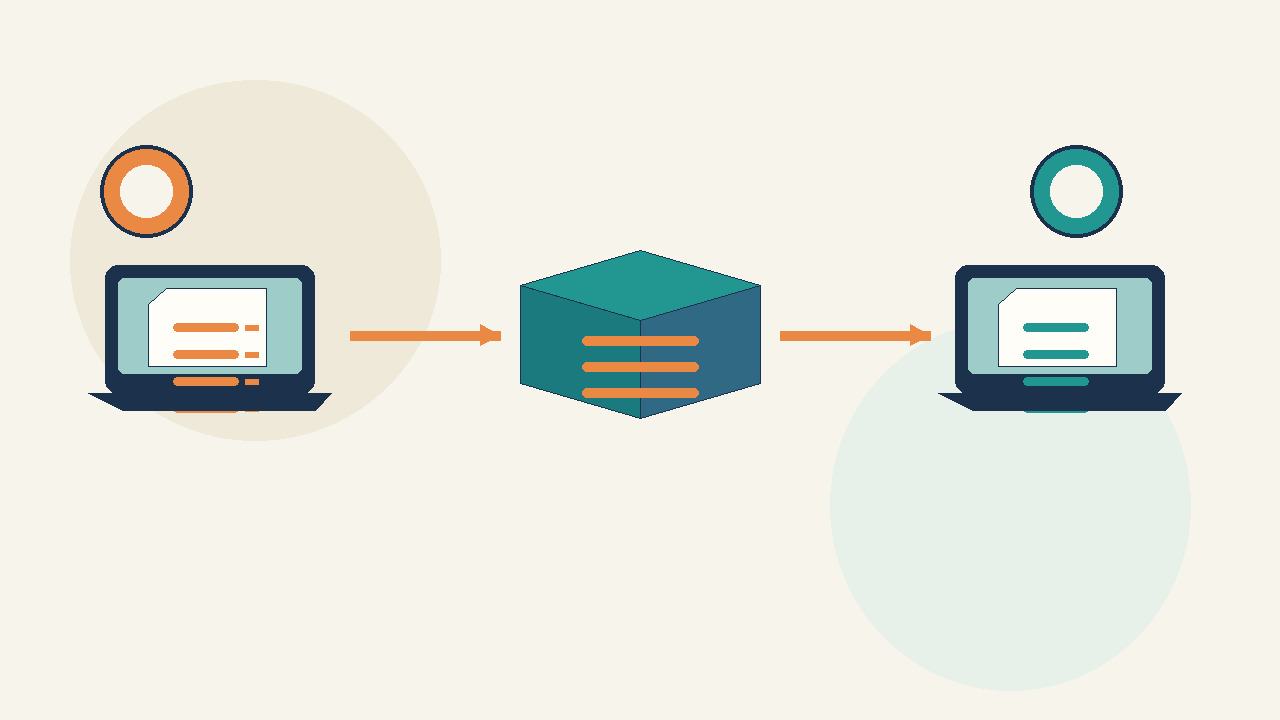
只改了一行业务代码,差异却显示整份文件都变了?Windows 常用 CRLF,Linux 常用 LF,编辑器保存时可能悄悄转换行尾。把规则写进仓库的 .gitattributes,就能减少这种噪声,让审查重新聚焦实际修改。
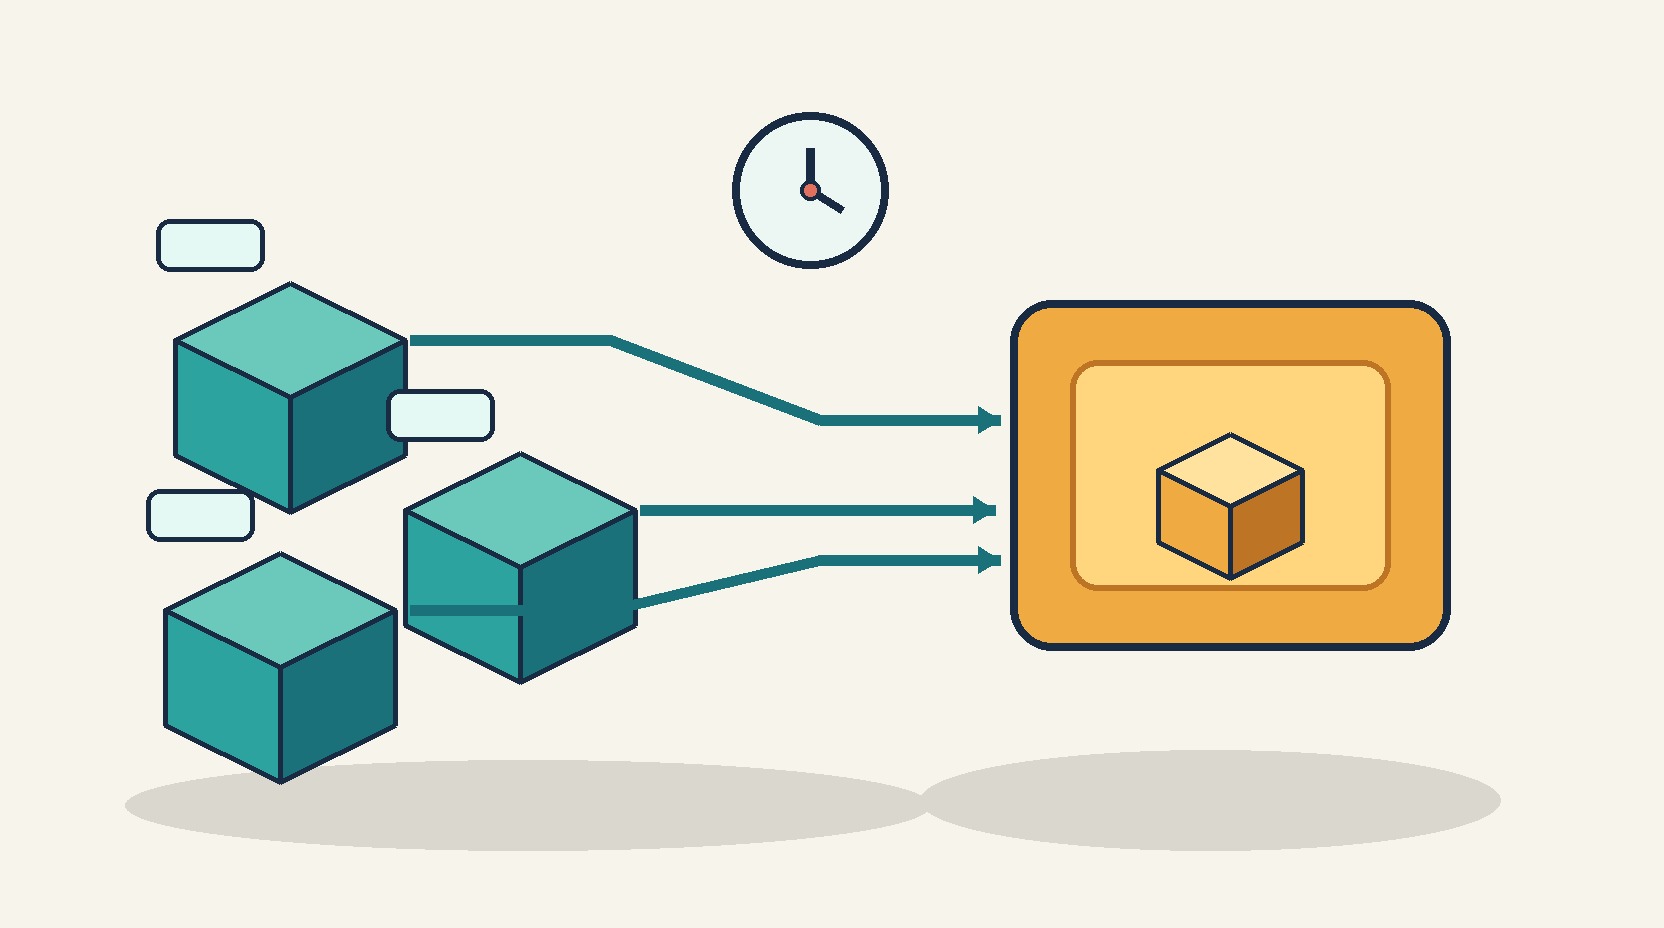
给一组按钮绑定处理函数,点击后却全部打印最后一个按钮的名称;批量创建延迟任务,任务执行时又都拿到了最后一个 ID。这类问题常被误以为是异步执行顺序错乱,真正原因通常是闭包对外层变量采用晚绑定:函数创建时保存的是变量本身,调用时才读取它当前的值。
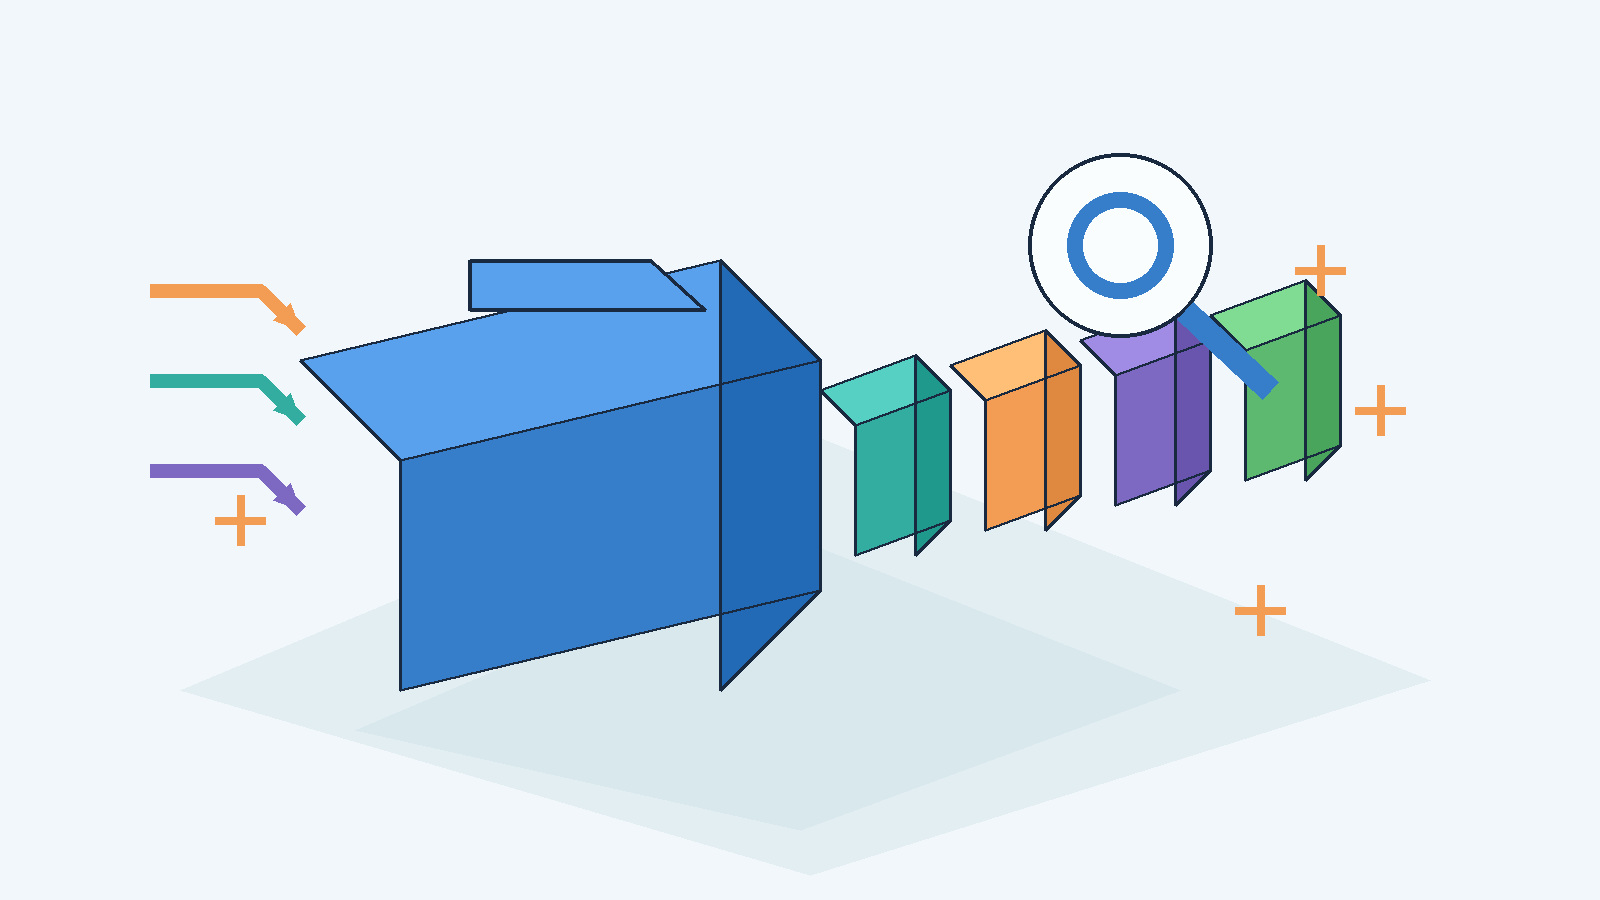
配置热加载、构建工具和同步服务都需要知道“文件变了”。轮询目录浪费 CPU,盲信通知又会在高峰期丢状态。inotify 只提供事件流,不保证永不丢失,也不维护目录快照。监听、去抖和重扫组合起来,文件监控才能长期运行。
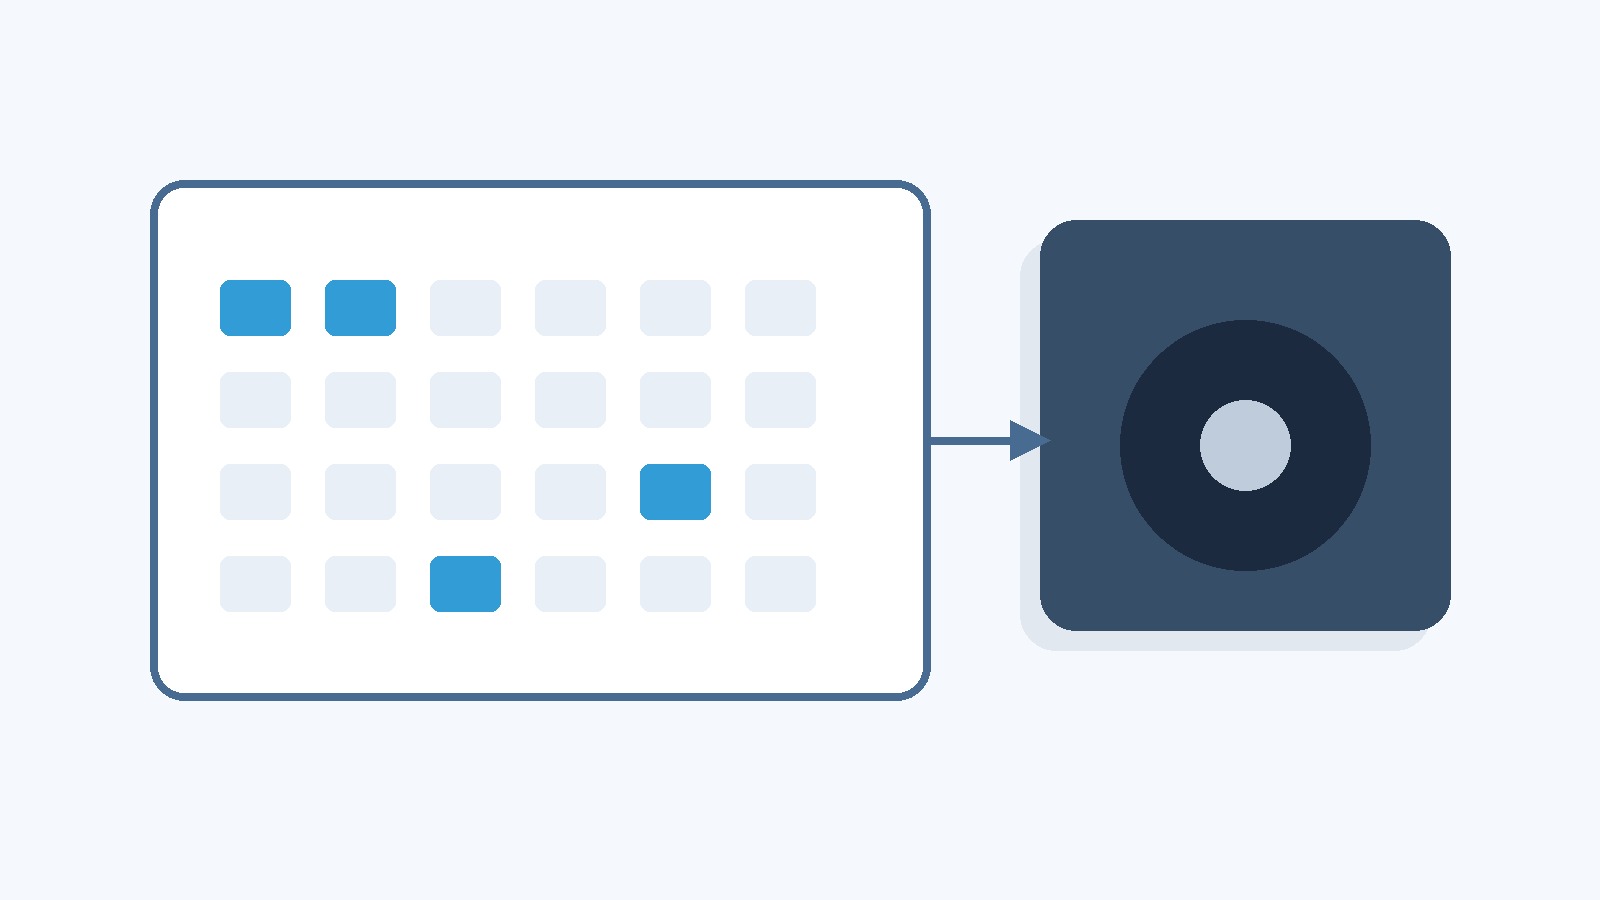
排查磁盘时,ls -lh 显示文件有几十 GB,du -h 却说只占几 MB,未必是工具出错。它们回答的是两个不同的问题:文件有多长,以及文件系统已经为它分配了多少空间。稀疏文件正好把这两个数字拉开;弄清空洞的含义,才能正确估算复制、备份和后续写入所需的容量。
代码评审能说明“谁看过改动”,却不能单独证明“这个提交确实由某个身份创建”。当仓库允许机器人合并、镜像同步或多人代提交时,提交者姓名和邮箱只是可编辑的文本。给提交加上数字签名,再让本地和 CI 按规则验证,才能把变更和密钥身份连起来。本文用 Git 原生能力搭一条可操作的信任链。