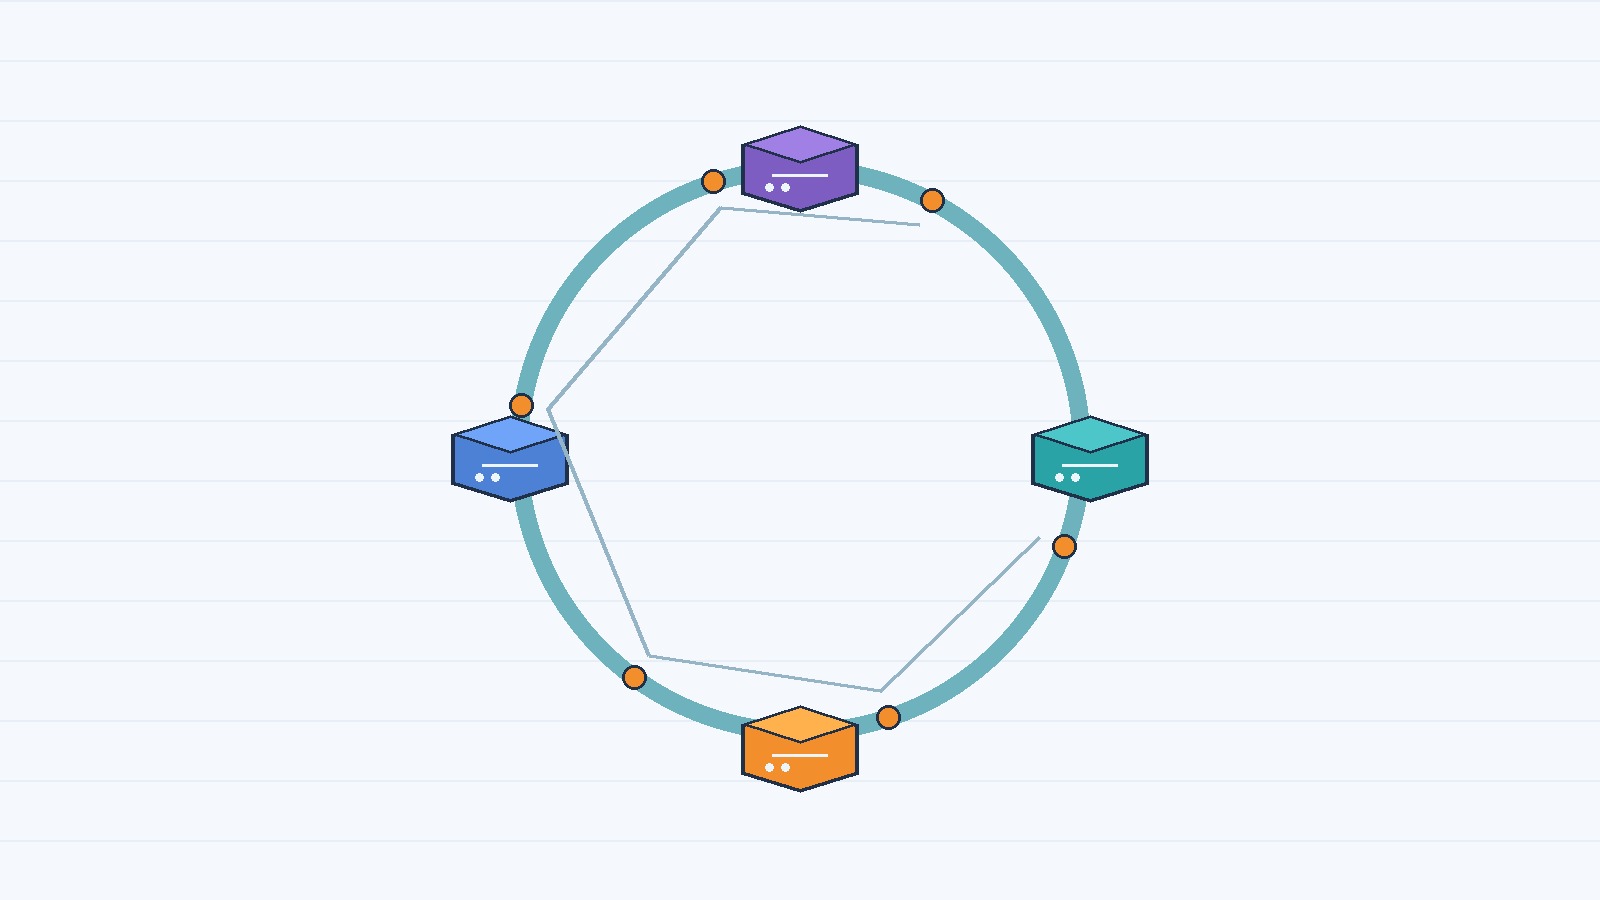
一个缓存集群从三台机器扩到四台,最麻烦的可能不是加机器,而是原有键突然找不到了:请求按新规则去了别的节点,大量未命中同时回源。一致性哈希解决的是“节点名单变化时,尽量少改键的归属”这个路由问题。它适合客户端自行选择缓存节点的场景,但并不替代缓存失效和数据一致性设计。
一个缓存集群从三台机器扩到四台,最麻烦的可能不是加机器,而是原有键突然找不到了:请求按新规则去了别的节点,大量未命中同时回源。一致性哈希解决的是“节点名单变化时,尽量少改键的归属”这个路由问题。它适合客户端自行选择缓存节点的场景,但并不替代缓存失效和数据一致性设计。
用户只改个人资料里的一个字段时,提交完整对象会增加网络开销和覆盖风险。部分更新 API 的关键,是把字段变化、数组处理和空值含义写成可执行的契约。本文比较 JSON Patch 与 JSON Merge Patch,并给出校验与并发控制方案。

一次读入百万行再处理,代码直观,却把内存峰值和首条结果的等待时间都绑在数据规模上。生成器把“先生产完、再交付”改成“需要一个、计算一个”,适合日志扫描、批量导入和分页接口。不过,惰性求值也带来一次性消费、异常延迟和资源关闭等新边界。

长分支反复 rebase、发布分支持续回合并、补丁在多个版本间 cherry-pick 时,同一处冲突可能一再出现。人工每次都重新判断,不仅浪费时间,还可能给出前后不一致的答案。Git 内置的 rerere(reuse recorded resolution)能记录一次冲突的解决前后状态,在相同冲突再次出现时复用结果。

事件一旦进入消息队列,就可能被多个团队、不同版本的消费者读取,也可能在数月后被重新回放。此时一次看似普通的字段重命名,会变成跨服务的兼容性事故。治理事件 Schema 的关键不是永远不改,而是让新旧生产者和消费者在迁移窗口内都能正确工作。
Python 的鸭子类型很灵活:只要对象“看起来像”文件,就可以传给读取函数。但项目变大后,接口约定如果只存在于口头和文档里,重构时就容易变成运行期才暴露的 AttributeError。typing.Protocol 把这份约定写成可检查的结构,同时保留 Python 原有的低耦合和可替换性。

进程收到 SIGTERM 后要停止接流量,收到 SIGHUP 后要重载配置,看起来只需注册两个回调。然而信号处理函数会在不可预测的指令之间打断程序;若在里面加锁、分配内存或写日志,偶发死锁和状态损坏便可能随之而来。稳妥的思路是:处理函数只负责通知,把真正的工作交还主循环。

文件能正常关闭,不代表代码已经可靠:读取中途抛异常、获取第二个资源失败、函数提前返回,都可能绕过散落在各处的清理语句。Python 的上下文管理器把“获得资源”和“无论如何都释放资源”组成一个边界,让异常路径与正常路径共享同一套收尾逻辑。

排查跨服务故障时,常要把几个日志文件合成一条时间线。如果文件很大,全部读进列表再排序会占用大量内存。只要每个文件内部已经按同一规则排好序,就可以用多路归并逐条输出,让内存需求主要取决于输入路数。