调用外部命令时,测试环境里几行输出一切正常,到了 CI 却偶尔永远不退出。进程仍在、CPU 几乎为零,强制终止后也没有明确错误。问题往往不在命令本身,而在父进程只等退出、没有及时读取管道:日志把缓冲区写满后,双方就互相等待。
一次死锁是怎样形成的
把 stdout 或 stderr 设为 PIPE,相当于让内核维护一段容量有限的字节队列。队列有空间时,子进程的 write 很快返回;队列满后,继续写入会阻塞,直到父进程读走数据。容量是实现细节,不能把“本机能写多少”当成协议保证。
最典型的环路只有三步:父进程启动子进程后立即调用 wait;子进程不断写日志并填满管道;子进程等待读端腾出空间,父进程却等待子进程退出。此时子进程尚未退出,不是僵尸进程。stdout 与 stderr 还是两条独立管道,只读取其中一条,另一条照样可能塞满。
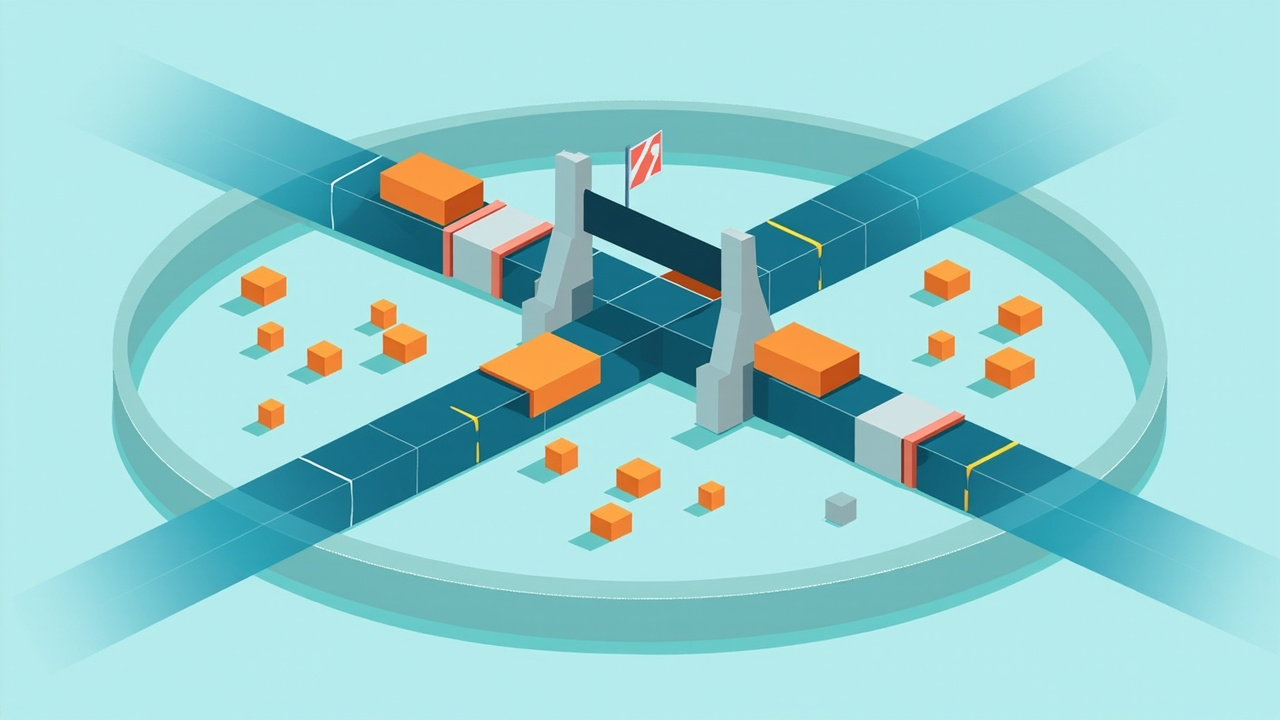
下面的程序故意让子进程向 stderr 写入大量数据,再演示错误的“先等待、后读取”。实际管道容量因系统而异,但死锁条件不变:
1 | import subprocess |
先按输出需求选择连接方式
不要习惯性地给两个通道都配置 PIPE。是否需要捕获、输出规模和是否实时展示,决定了更合适的连接方式。
| 需求 | 推荐方式 | 主要边界 |
|---|---|---|
| 不关心输出 | DEVNULL |
丢弃诊断信息 |
| 允许直接展示 | 继承父进程终端或文件描述符 | 不便程序化分析 |
| 少量、结束后处理 | run(capture_output=True) 或 communicate() |
全量结果占内存 |
| 大量、需要留存 | 直接重定向到文件 | 管理磁盘容量与轮转 |
| 持续、需要实时处理 | 同时流式读取两个通道 | 处理器必须持续推进 |
如果输入也是管道,不再发送数据时要关闭写端,让子进程收到 EOF;一次性输入则交给 communicate(input=...)。父进程意外保留的写端会让读取方一直等不到 EOF,看起来同样像“命令不退出”。
有界输出优先使用 communicate
输出确定较小时,communicate() 会同时发送输入、排空两个输出通道并等待退出,调用顺序不会制造上述死锁:
1 | proc = subprocess.Popen( |
Popen.communicate(timeout=...) 超时后不会替你终止进程,因此必须显式结束它,再次调用 communicate() 以排空剩余数据并完成回收。另一方面,它会把结果保存在内存里;输出可能达到数百 MB 时,应改用文件或有界流式处理。
大输出要同时、持续地排空
需要实时消费时,可以为两个通道各安排一个读取线程。下面只保留每路最近约 512 KiB,既持续解除背压,也避免日志无限吃掉内存:
1 | from collections import deque |
若完整日志必须保留,应在读取线程中写入有容量与轮转策略的文件;若要逐行展示,还要接受子进程缓冲输出或迟迟不写换行带来的延迟。这里的关键不是线程本身,而是两个通道始终有人读取,并且下游处理不会永久停住。
超时必须连同清理一起设计
超时只是一条检测信号,完整动作还应包括:停止继续写入 stdin,先请求子进程退出,宽限期后强制终止,继续排空输出,最后等待并记录退出状态。命令还会创建后代进程时,只杀直接子进程可能留下后台任务;POSIX 环境可在创建时使用独立会话,再按进程组终止,Windows 则需使用对应的进程组或 Job Object 机制。
上线前至少验证四种场景:两个通道同时大量输出、单行超长且没有换行、执行超时、子进程再创建后代。监控中记录命令、耗时、退出码、是否超时和被截断的日志尾部,但不要把密钥或完整参数原样写入日志。
子进程管理的可靠性来自一条简单原则:谁创建管道,谁就负责持续排空、关闭和回收。先明确输出去向,再把超时当成完整生命周期,而不是给 wait 随手加一个数字,许多 CI 假死和线上任务悬挂都会在设计阶段消失。