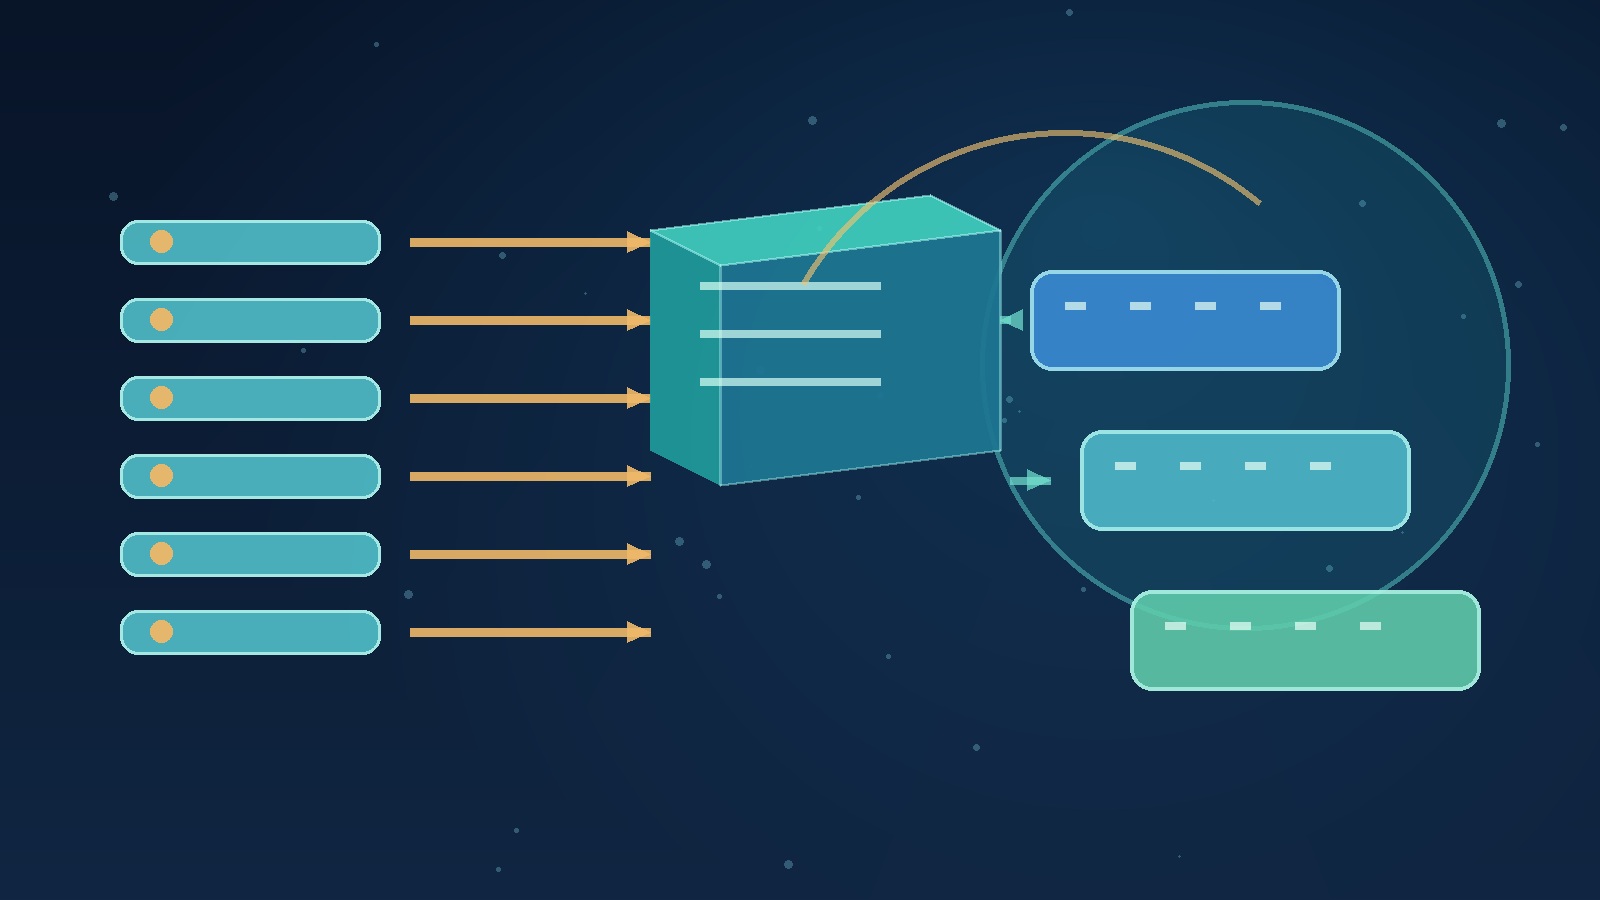
很多键值数据库和写入密集型系统,都把“随机写”改造成“顺序写”。理解这条路径,才能解释为什么写入很快、为什么读放大会突然出现,以及磁盘空间为何会在压缩期间短暂上涨。LSM-Tree 不是一棵需要原地平衡的树,而是一组按阶段生成、再逐步合并的有序文件。
一次写入经过哪些层
应用写入通常先追加到预写日志(WAL),再放入内存中的 MemTable。WAL 让进程崩溃后可以重放尚未刷盘的记录;MemTable 负责把新值按 key 排序,并快速回答最近写入。它达到阈值后被冻结为 Immutable MemTable,由后台线程写成磁盘上的 SSTable(Sorted String Table)。
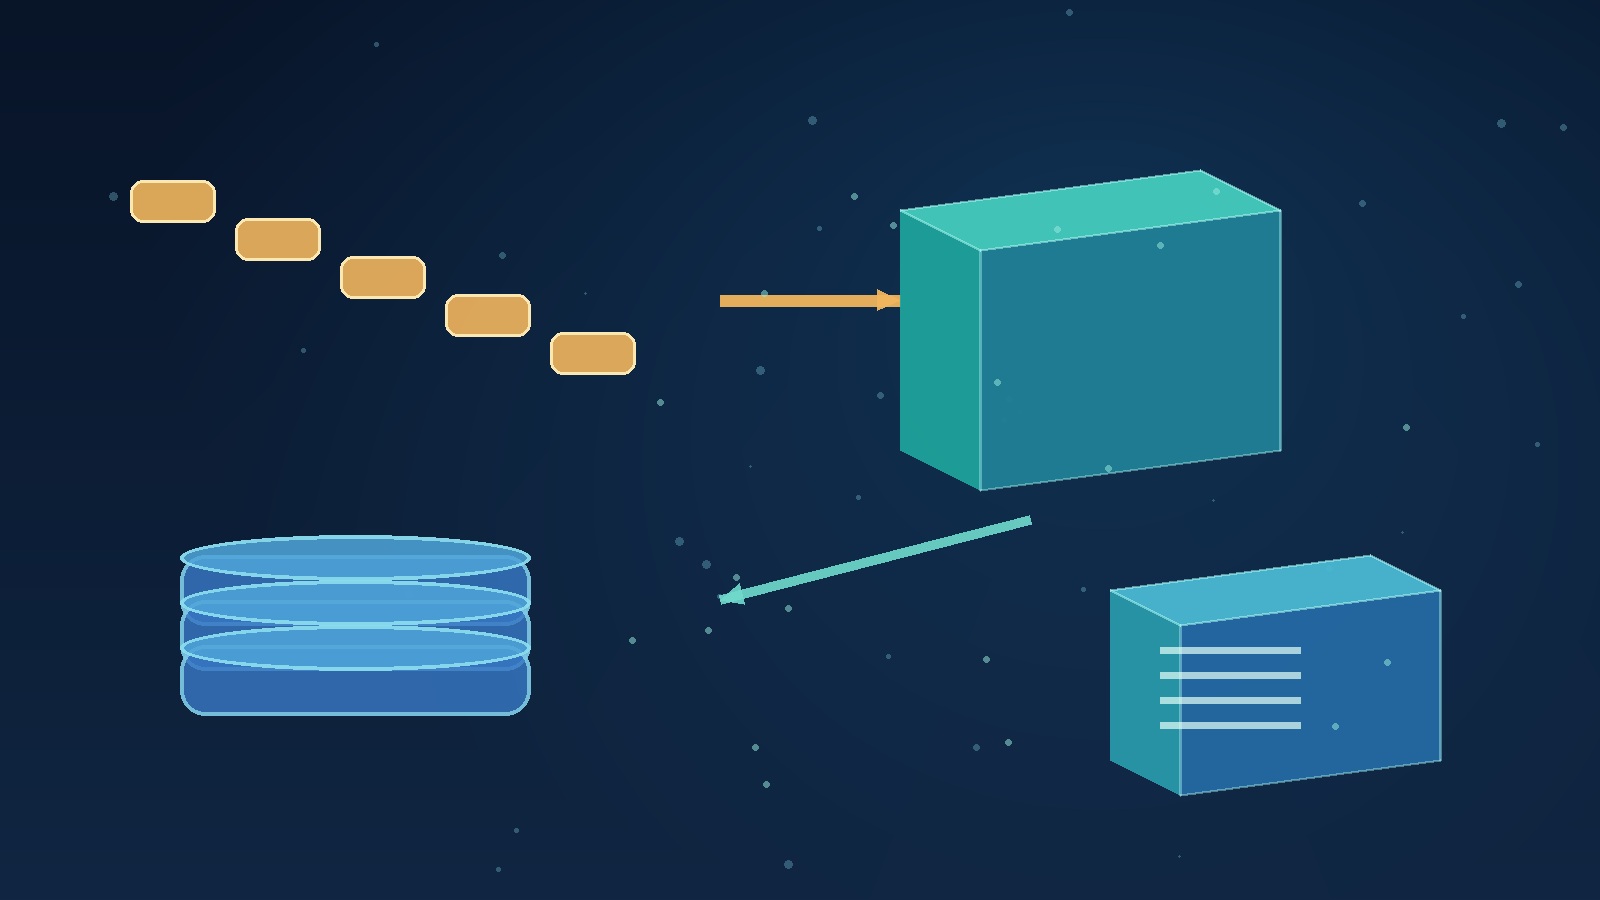
可以把核心顺序概括成下面的伪代码:
1 | put(key, value): |
三者职责要分开:WAL 负责恢复,MemTable 吸收突发写入,SSTable 持久化有序数据。SSTable 通过索引和布隆过滤器跳过不可能命中的文件。
读路径为什么会变复杂
读一个 key 时,系统一般按“新到旧”检查:当前 MemTable、Immutable MemTable,再查各层 SSTable。越新的层越可能包含覆盖值,因此同一个 key 可能在多个文件中出现。删除也不能直接抹掉旧文件里的值,而要写入带序号的 tombstone,等合并时再安全清理。
| 组件 | 主要作用 | 常见风险 |
|---|---|---|
| WAL | 崩溃恢复、保证写入顺序 | 文件过大导致恢复变慢 |
| MemTable | 吸收写入、提供最新值 | 内存上限过小会频繁刷盘 |
| SSTable | 持久化有序数据 | 文件层数增加会放大读放大 |
| Bloom Filter | 过滤“不可能存在”的 key | 误判只能减少,不能保证零误判 |
SSTable 通常带有稀疏索引、数据块校验和压缩。读取先过 Bloom Filter,再定位数据块;缓存未命中时仍会受到随机读影响,所以“写入快”不等于“读取永远快”。
Compaction 是稳定性的关键
后台 Compaction 会把多个重叠文件合并成更少、更大的有序文件,丢弃被覆盖的旧版本和已经安全的 tombstone。常见策略各有取舍:分层(leveled)让每一层的 key 范围尽量不重叠,读放大较低,但合并会反复改写数据;分组(tiered)先积累同层文件再合并,写放大较小,却可能留下更多候选文件。
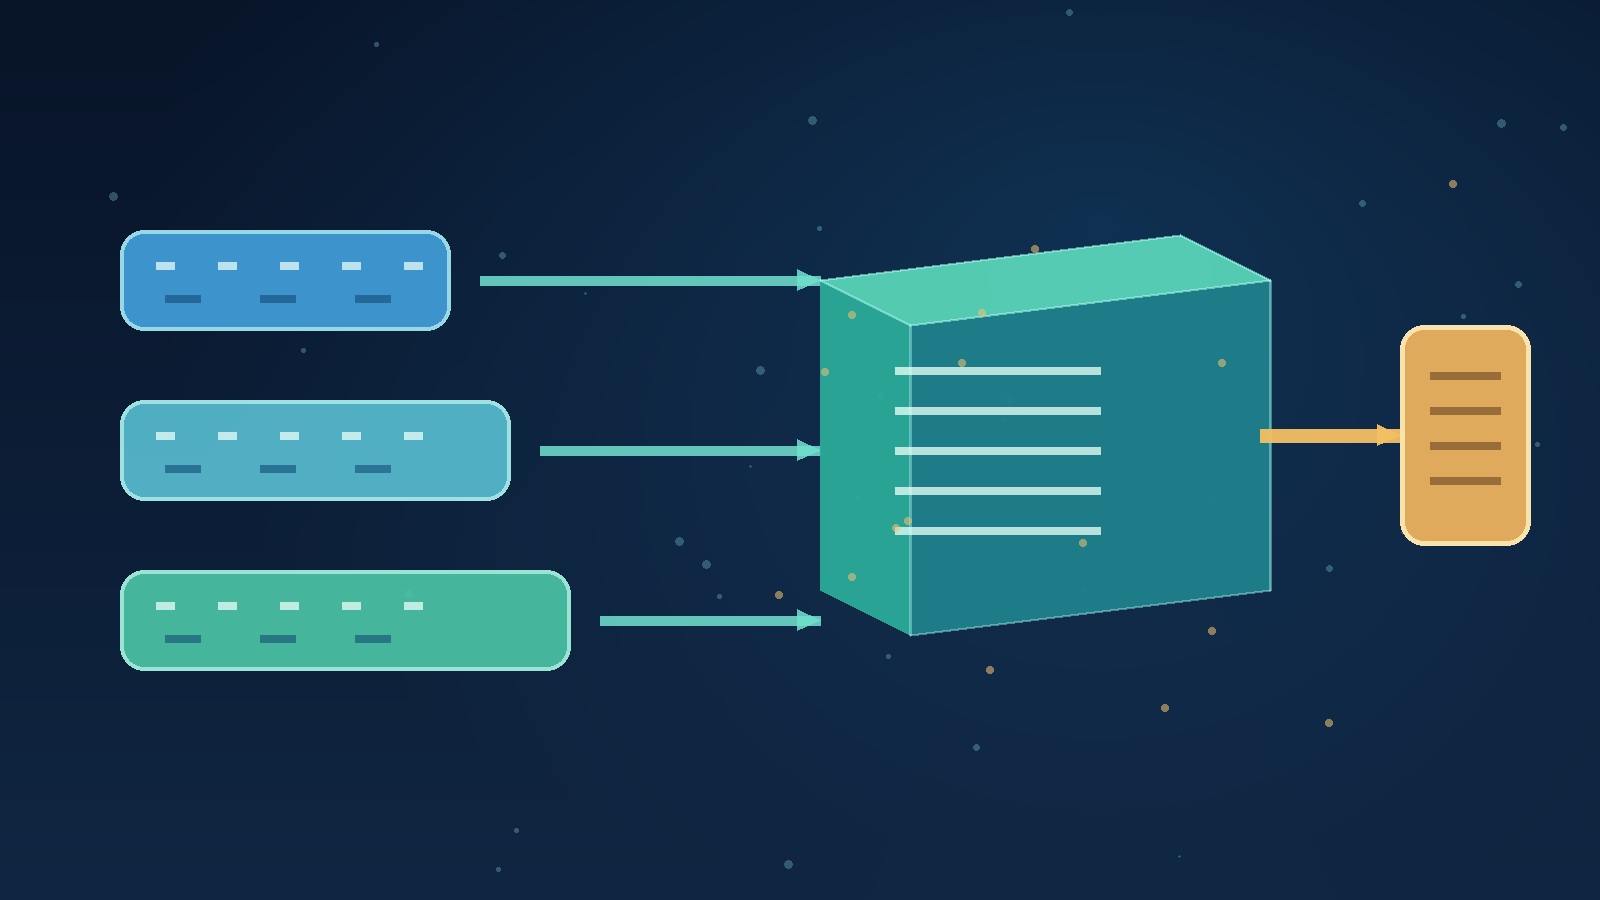
生产环境要观察三种放大:写放大是数据被重写的次数,读放大是一次查询检查的文件或数据块数量,空间放大是旧版本和临时文件占用的磁盘。压缩线程过少会拖高读放大,过多又会争抢 CPU、磁盘带宽和缓存。
一份可落地的调参清单
- 先按业务写入峰值设置 MemTable 大小和 WAL 保留策略,确认重启恢复时间可接受。
- 给 SSTable 的数据块、索引和 Bloom Filter 分配独立的缓存观测指标,不要只看命中率总数。
- 为 Compaction 设置磁盘空间水位和限速,给前台写入预留带宽;空间不足时让写入背压,而不是继续生成文件。
- 用带版本号的读写压测记录 p50、p99、写放大和 pending compaction bytes;备份要保存快照边界与 WAL 截断点,恢复后校验 key 数量和业务不变量。
LSM-Tree 的工程重点不是“把数据写进内存再落盘”,而是让恢复、读取、压缩和资源上限形成闭环。只要把每一层的职责、放大来源和背压信号都暴露出来,写入性能与长期可维护性就能一起评估。