当一个仓库需要复用另一个独立维护的仓库时,Git Submodule(子模块)可以保留清晰的边界:主仓库记录组件仓库的某个提交,而不是把组件源码复制进来。但子模块也很容易变成“目录里有代码、发布时却不是这份代码”的隐形风险。把提交钉住、更新流程和 CI 校验写清楚,才能让它适合长期维护。
子模块到底记录了什么
主仓库的提交不会保存子模块文件内容,只保存一个特殊的 gitlink:它指向子模块仓库中的具体 commit。同时,.gitmodules 保存子模块路径和远端 URL。例如:
1 | [submodule "libs/parser"] |
因此,主仓库的 main 前进了,不代表子模块自动前进。执行 git status 时,如果子模块工作区位于另一个提交,主仓库会显示一个修改过的子模块目录。这个差异不是普通文件 diff,必须进入子模块单独查看:
1 | git -C libs/parser status |
| 场景 | 主仓库记录 | 常见风险 |
|---|---|---|
| 首次添加 | 子模块 commit + .gitmodules |
忘记提交 .gitmodules |
| 更新组件 | 新的子模块 commit | 只在本地更新,未提交 gitlink |
| 克隆项目 | 先得到空目录 | 忘记初始化导致构建缺文件 |
| 切换分支 | gitlink 可能改变 | 工作区残留旧版本 |
先把克隆和更新流程固定下来
新成员拿到仓库时,推荐直接递归初始化:
1 | git clone --recurse-submodules https://example.com/team/app.git |
已经克隆完成的仓库可以补做同样的初始化:
1 | git submodule update --init --recursive |
--recursive 很关键,因为子模块还可以包含自己的子模块。日常同步时不要把“拉取远端分支”和“切换主仓库记录的提交”混成一个动作。用于复现当前版本的命令是:
1 | git fetch --all --prune |
它会把每个子模块检出到主仓库已经记录的 commit,而不是擅自跟踪子模块的 main。如果确实要升级依赖,应在独立分支中进入子模块,选择经过测试的新提交,再回到主仓库提交 gitlink:
1 | git -C libs/parser fetch origin |
把脏工作区和来源变化挡在提交前
子模块最容易出现的误操作,是开发者在子模块里产生了未提交改动,却只提交了主仓库。主仓库只看得到 gitlink 变化,真正的改动可能留在本地,换一台机器就消失。提交前可以使用脚本逐个检查:
1 |
|
还要审查 .gitmodules 的 URL。若组件仓库迁移,先修改 URL,再用 git submodule sync --recursive 同步本地配置;不要只改开发者机器上的 .git/config,否则 CI 和其他成员仍会访问旧地址。
CI 至少做三项校验
CI 不应只在主仓库执行测试,还应确保子模块可被干净地取回。一个最小的检查步骤如下:
1 | git submodule sync --recursive |
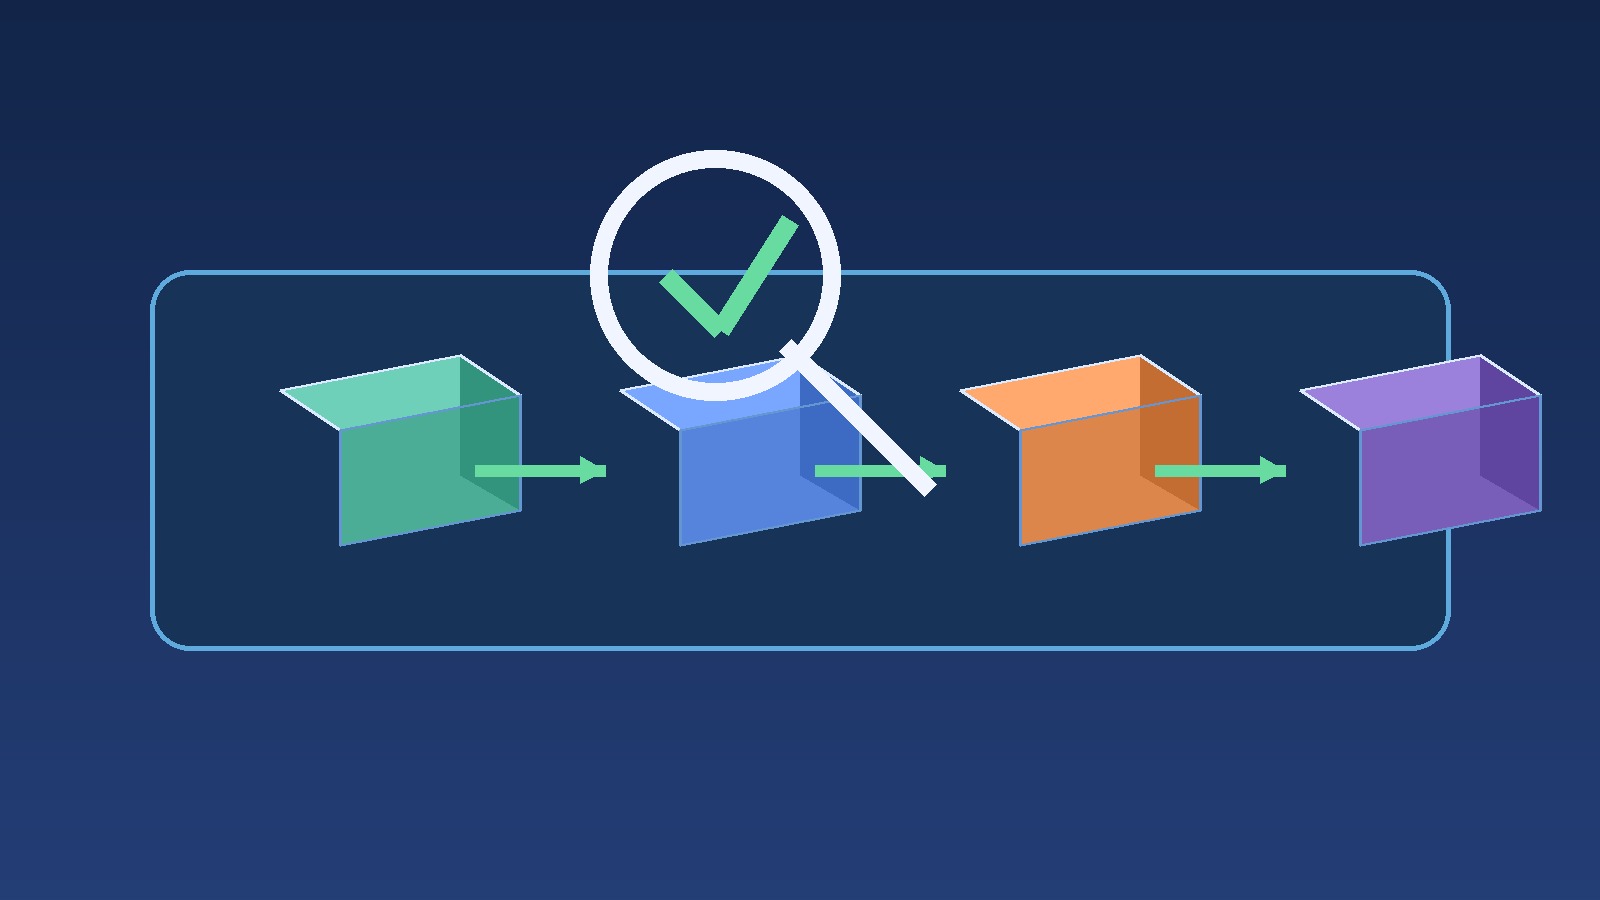
如果子模块是私有仓库,CI 还需要明确的只读凭据和最小权限;不要把带令牌的 URL 写进 .gitmodules。对于发布制品,建议把主仓库 commit、每个子模块 commit 一起写入构建元数据,这样出现回归时可以准确回答“发布的组件到底是哪一版”。
什么时候应该换方案
子模块适合组件需要独立版本、独立权限或独立发布节奏的场景。如果团队总是同时修改主仓库和组件,频繁跨仓库提交会让评审和回滚变得繁琐,可以考虑单仓库目录、包管理器或构建时拉取依赖。无论采用哪种方案,核心原则都是相同的:依赖版本要可追溯,更新要经过测试,干净克隆必须能够复现构建。