订单状态、构建日志和后台任务进度这类信息,往往只需要服务端持续推给页面。Server-Sent Events(SSE)比双向协议更轻:一个普通 HTTP 响应保持打开,浏览器的 EventSource 会在连接中断后尝试重连。但“能收到消息”不等于“稳定送达”。代理缓冲、空闲超时和重连窗口里的事件缺口,都会让页面看起来偶发失效。
订单状态、构建日志和后台任务进度这类信息,往往只需要服务端持续推给页面。Server-Sent Events(SSE)比双向协议更轻:一个普通 HTTP 响应保持打开,浏览器的 EventSource 会在连接中断后尝试重连。但“能收到消息”不等于“稳定送达”。代理缓冲、空闲超时和重连窗口里的事件缺口,都会让页面看起来偶发失效。
两位用户同时编辑同一份资料,是后台系统里非常常见的场景。若接口只接受一个普通的 PUT 或 PATCH,后提交的请求会悄悄覆盖先提交的修改:两次都返回 200,数据却已经丢失。数据库事务能保护单条 SQL 的原子性,却不会替 HTTP 客户端判断“我编辑的还是不是刚才看到的版本”。
一次下游服务变慢,往往不会只影响一个请求:等待中的线程、连接池和重试会继续堆积,最后把原本健康的调用方也拖垮。熔断器(Circuit Breaker)不是“请求失败就拒绝”的开关,而是一套让故障隔离、恢复探测和业务降级各归其位的状态机。
页面已经打开,接口也很快,但点击筛选、展开弹窗或输入搜索词时仍会“顿一下”。这类问题经常不在服务端,而是某段同步 JavaScript 长时间占住了浏览器主线程:输入无法处理,样式和布局不能提交,下一帧也画不出来。与其凭感觉删代码,不如先记录长任务发生的时间、持续时间和业务动作,再做有证据的优化。
很多服务把 /health 写成“能响应就返回 200”。上线初期它看似足够,直到数据库抖动、连接池耗尽或进程进入假死:该重启的实例没有重启,该摘流量的实例仍在接请求。健康检查不是一盏绿灯,而是给编排器、负载均衡器和告警系统的操作信号。
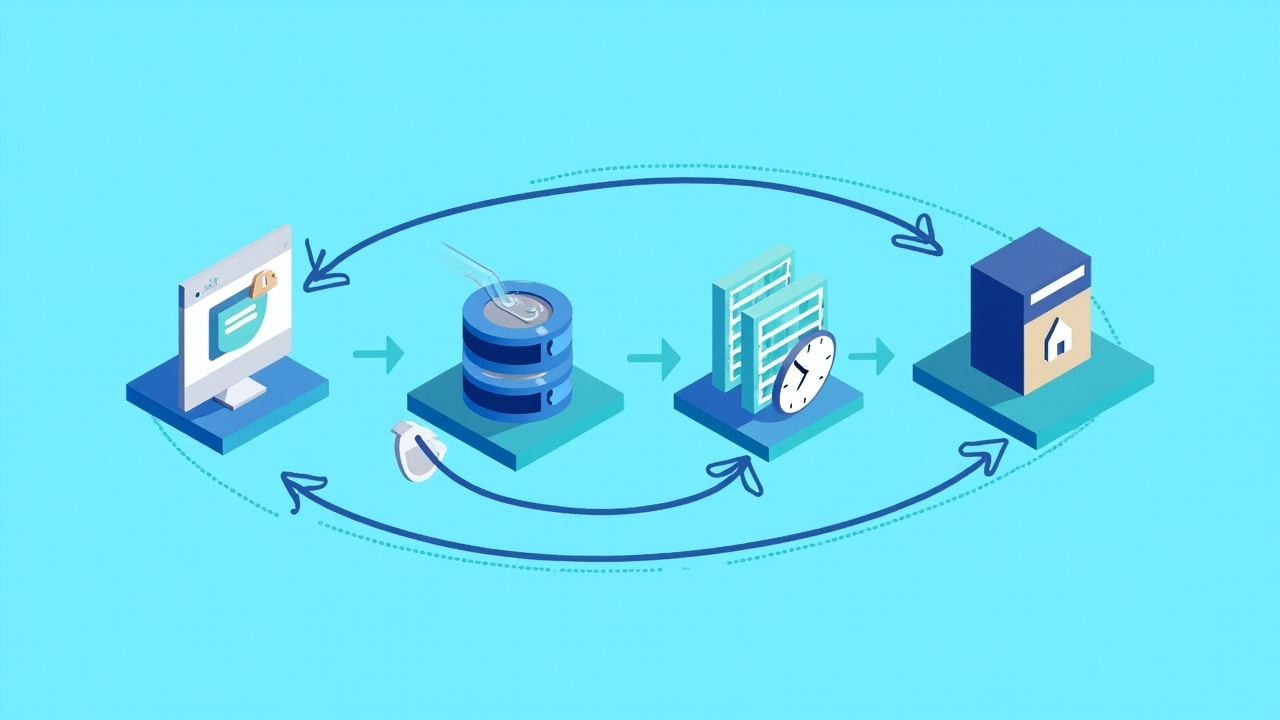
业务常把“删除”理解为暂时不让用户看见,于是给表加上 deleted_at 就上线。几个月后,重复注册被唯一索引拦住、后台统计混入已删除数据、关联记录变成孤儿,恢复操作又覆盖了新数据。软删除不是一个字段,而是一套从可见性、约束到最终清理的生命周期协议。
列表接口在测试数据上很快,上线后却随着分页条数变大而变慢,常见原因不是少了索引,而是 ORM 在循环里偷偷访问关联对象:先查一页主记录,再为每条记录各发一次查询。这类 N+1 问题的危险在于单条 SQL 很快,却会放大网络往返、连接占用和数据库解析成本。治理它的重点不是“多写一个 include”,而是让一次请求的查询数量可见、可预测、可回归。
“能在我电脑上打出来”只说明构建曾经成功,不代表它可验证、可迁移。更可靠的目标是:在相同声明的输入下,两台独立环境产出字节完全相同的制品。这样,无论是排查发布差异、复核第三方构建,还是追踪供应链异常,都有一个明确的比较基线。

订单号在服务端是合法的 int64,到了浏览器却少了一位;请求仍成功,只是更新错了记录。根因常在“JSON 数字如何解析”没有写进接口契约。先定清取值范围、语义和编码,才能避免静默的数据损坏。

“服务可用”常常只是一句模糊的期待:出了故障才发现用户受影响,告警又多到没人相信。SLO(服务等级目标)把这种期待变成可度量的承诺;错误预算则告诉团队,在不牺牲可靠性的前提下还能承受多少失败。