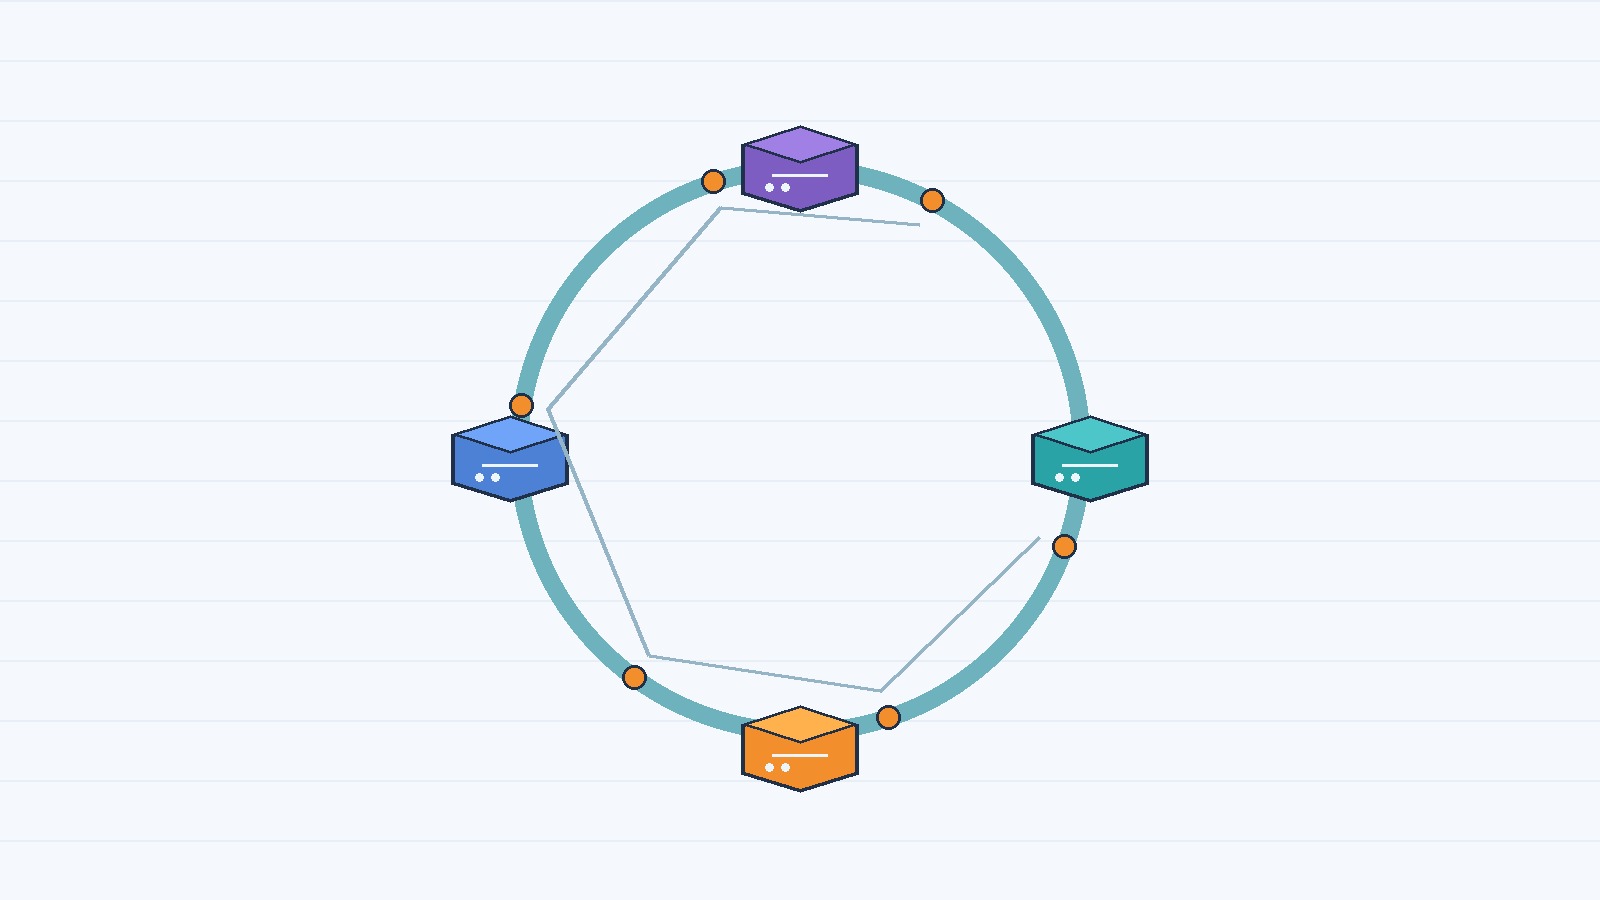
一个缓存集群从三台机器扩到四台,最麻烦的可能不是加机器,而是原有键突然找不到了:请求按新规则去了别的节点,大量未命中同时回源。一致性哈希解决的是“节点名单变化时,尽量少改键的归属”这个路由问题。它适合客户端自行选择缓存节点的场景,但并不替代缓存失效和数据一致性设计。
取模为什么会引发大面积迁移
最直观的路由是 hash(key) % N,其中 N 是节点数。它在节点集合固定时很简单;从三台变四台后,分母变了,许多键即使原节点仍在线,也会被分到新位置。对缓存而言,这些键相当于集体冷启动;对持久化分片而言,还意味着真实的数据搬迁。
| 路由方式 | 节点增加后的变化 | 主要代价 |
|---|---|---|
| 直接取模 | 大量旧键重新归属 | 集中未命中或搬迁 |
| 一致性哈希 | 通常只改落入新节点负责区间的键 | 环分布可能不均 |
把节点和键放到同一条环上
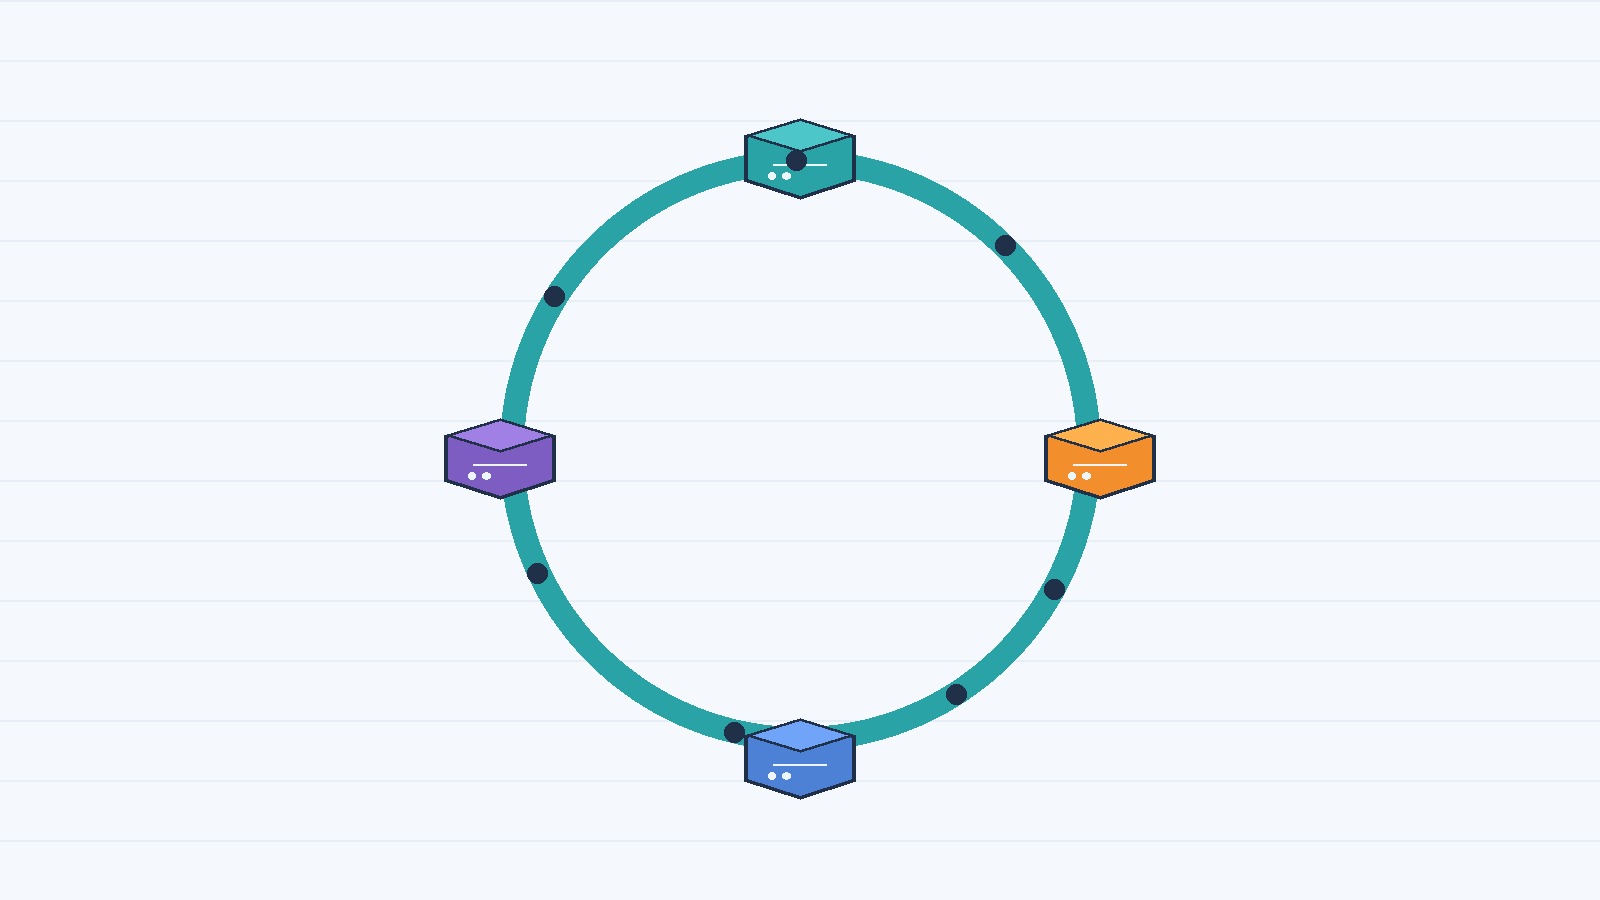
把哈希值想象成首尾相接的圆环。每个节点占据环上的一个位置;键也映射到环上,并由顺时针遇到的第一个节点负责。新增节点只接管它与逆时针前一个节点之间的区间;删除节点时,原属它的键交给顺时针后继。其他区间的路由保持不变。
实现时,所有客户端必须使用相同的哈希算法、节点标识和节点列表版本。不能用 Python 内置的 hash() 作为跨进程路由依据,因为它对字符串的结果可能因进程而异。下面用 SHA-256 的前八个字节生成稳定位置,二分查找顺时针节点:
1 | from bisect import bisect_left |
这里的 node: 和 key: 是域分隔,避免同一字符串意外扮演两种角色。生产环境还要固定字符串编码与节点 ID 的规范,并把路由配置作为一个整体发布,防止不同客户端暂时把同一键写到不同节点。
虚拟节点让分布更平滑
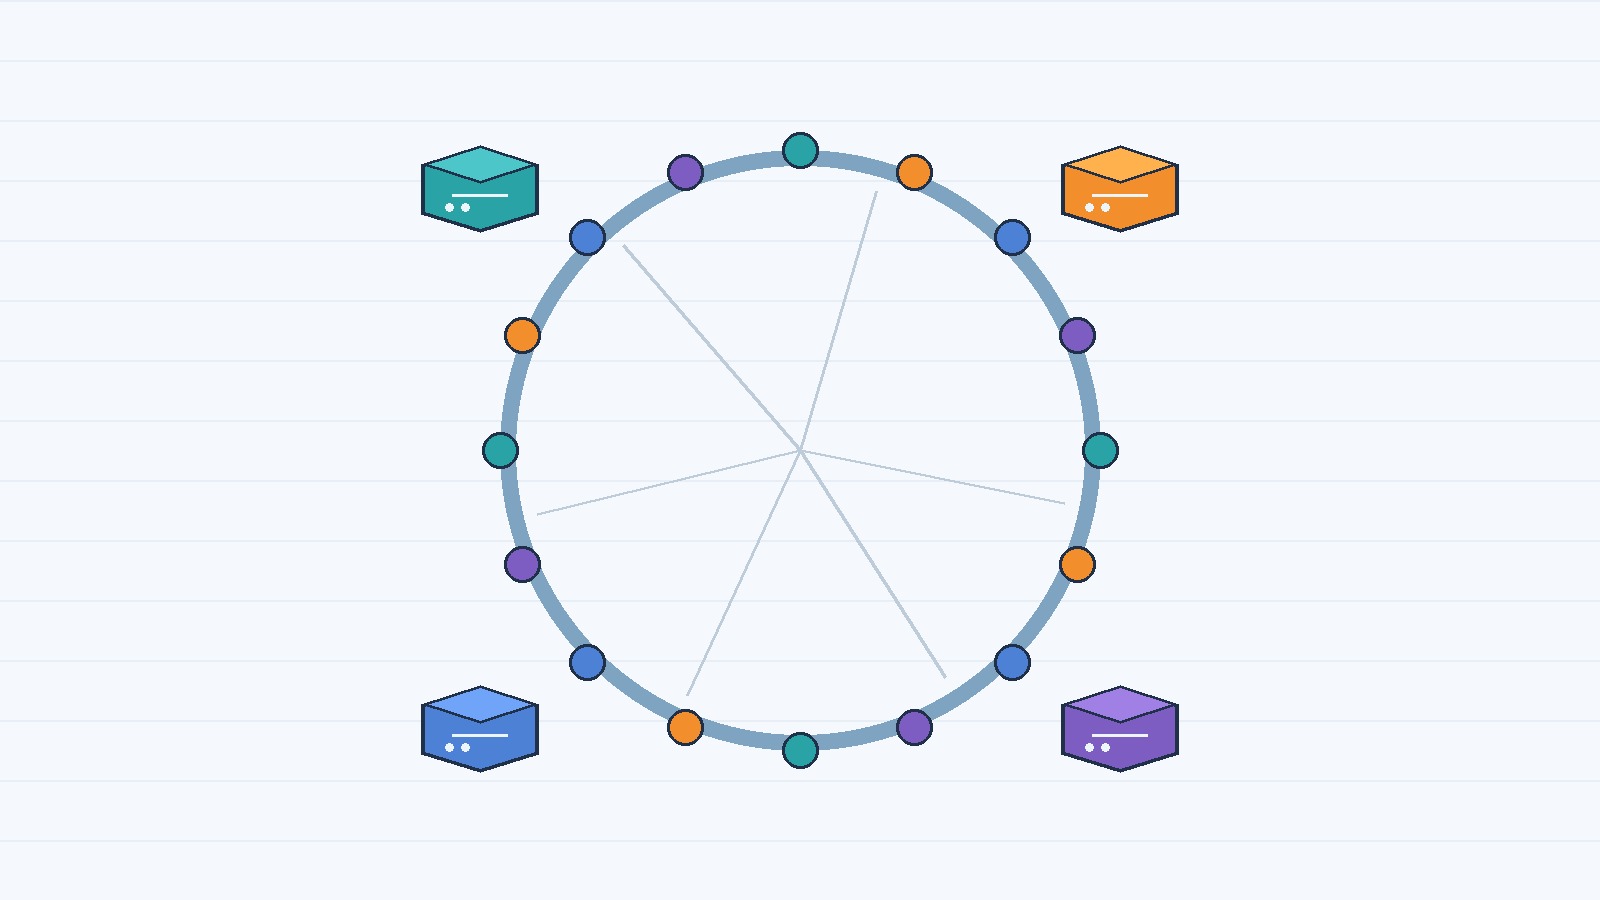
如果每台机器只有一个环位置,少量节点容易分出大小悬殊的区间。代码中的 replicas=64 会把每台物理节点映射到多个位置,让它负责分散的小区间;节点增减时,迁移也分散在环上。虚拟节点越多,通常越容易均衡,但路由表和构建成本也会增加。机器容量不同,可以分配不同数量的虚拟节点,先压测再定权重。
上线前还要处理的边界
一致性哈希减少路由变化,不保证单个热点键被摊开:一个极热键仍只落在一台机器。可针对热点做副本或请求合并,但需要单独设计读写语义。若节点是缓存,扩容后的新归属会产生冷未命中,应限制回源并分批引流;若节点保存权威数据,则必须先迁移数据,再切换路由,必要时短期双读,不能只更新节点列表。
最后用一批固定键分别在扩容前后计算归属,记录迁移比例和各节点键数;上线时同时观察未命中率、回源量和节点负载。路由算法只回答“该去哪里”,这些检查才能确认扩容过程是否真的平稳。