同一资源可能需要 JSON、HTML 或不同语言版本。与其把分支塞进 URL 和 User-Agent,不如让客户端声明偏好,服务端按规则选择表示,并在响应头中说明结果。
资源、表示与四个请求头
/reports/42 是资源标识,JSON、HTML 是它的不同表示。常用协商维度如下:
| 请求头 | 选择什么 | 响应头 |
|---|---|---|
Accept |
媒体类型 | Content-Type |
Accept-Language |
语言 | Content-Language |
Accept-Encoding |
压缩算法 | Content-Encoding |
Accept-Charset |
字符集 | Content-Type 参数 |
媒体类型决定内容结构,编码只决定传输压缩方式。Content-Encoding: gzip 仍可能对应 application/json,不要把两者混为一谈。
按权重选择,而不是猜测
客户端可以用 q 表达偏好:
1 | Accept: application/json; q=1.0, text/html; q=0.6, */*; q=0.1 |
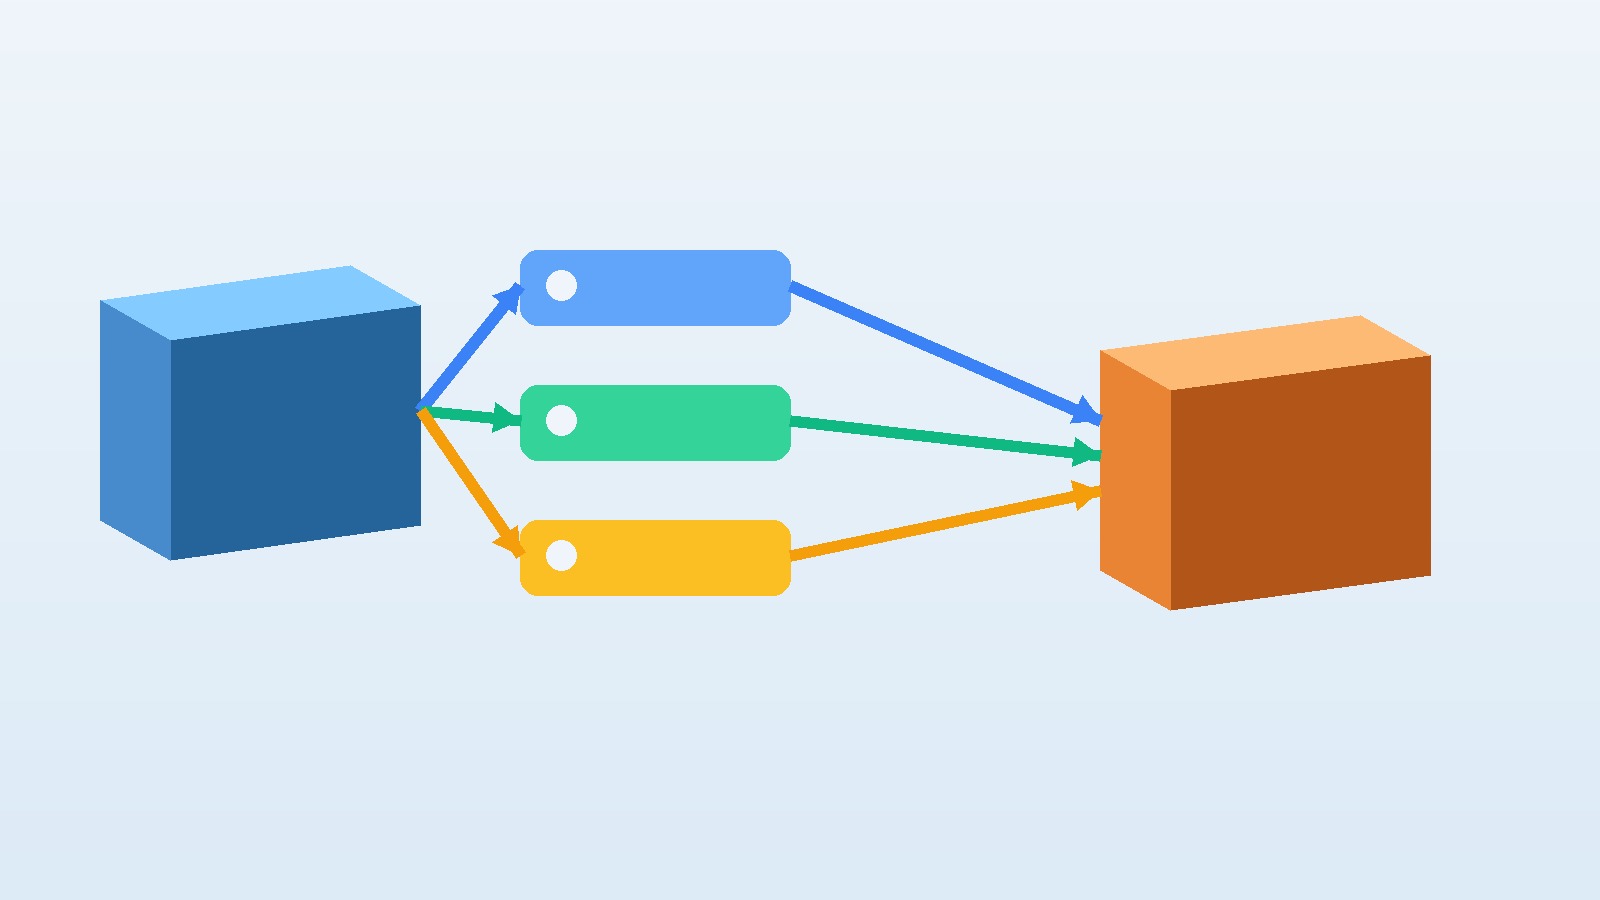
服务端可按四步处理:
- 过滤不支持的媒体类型、语言和编码。
- 按
q从高到低排序,同权重使用稳定的服务端优先级。 - 选择能同时满足这些维度的组合。
- 写出
Content-Type、Content-Language、Content-Encoding。
没有可用表示时返回 406 Not Acceptable;上传的 Content-Type 不支持时返回 415 Unsupported Media Type。*/* 只是兜底偏好,不代表可以返回任意内容。
把选择逻辑收口
不要在控制器里到处做字符串包含判断。将请求头解析为带权重的列表,再交给纯函数,边界更容易测试:
1 | SUPPORTED = [ |
解析器要处理大小写、空白、重复项和非法 q 值。非法值应记录并采用明确默认值,不能意外获得最高优先级。若 API 只承诺 JSON,统一返回 JSON 错误也比偶尔返回 HTML 错误页稳定。
Vary 让缓存知道差异
不同语言或格式会产生不同正文,响应要声明参与选择的请求头:
1 | Content-Type: application/json |
共享缓存会把 Vary 中的字段纳入缓存键。漏写可能把中文发给英文用户;加入高基数的 User-Agent 又会让缓存几乎无法命中。只列真正影响选择的字段,并用代理集成测试验证命中和未命中。
三个容易踩坑的边界
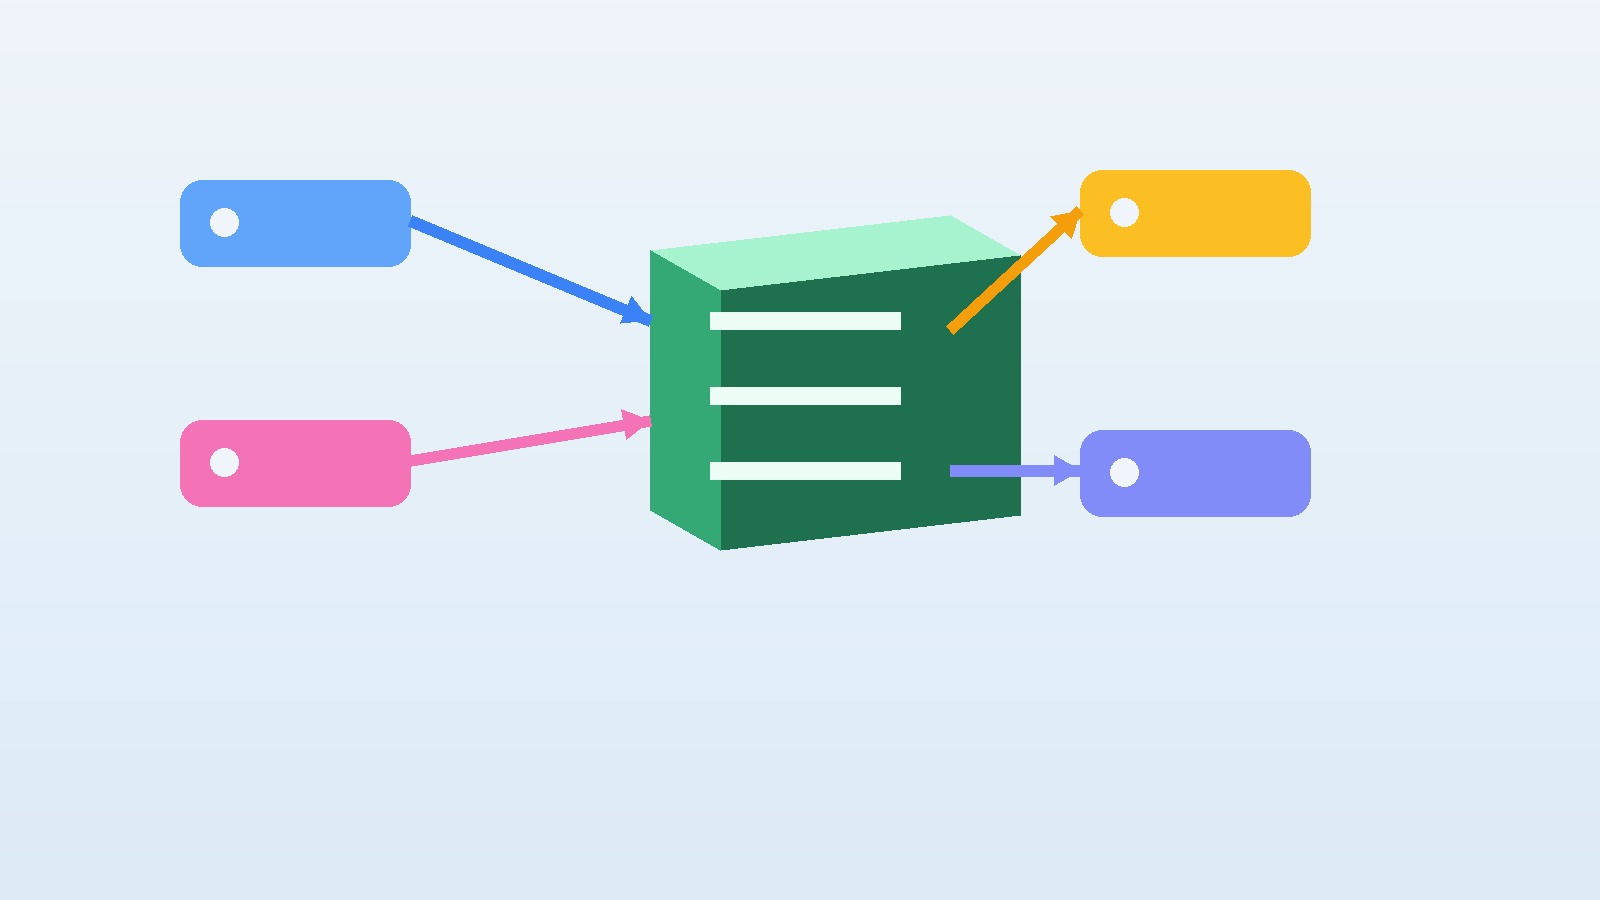
第一,Accept-Language 是偏好,不是身份认证。用户登录后选择的界面语言应由账户设置或显式参数覆盖,并避免把完整请求头原样写入缓存键。第二,服务端选择了默认表示时仍应返回明确的 Content-Type,不能让客户端靠猜测正文。第三,压缩协商与安全策略要分开,解压失败属于传输层错误,不能被包装成业务校验失败。
测试时为每个维度准备最小矩阵:首选项命中、首选项不支持、通配符兜底和非法权重。再用真实代理发送两次相同请求,确认 Vary 让不同表示不会互相污染。
用表示版本平滑演进
可以用 application/vnd.example.report+json;v=2 让 Accept 表达客户端能力,也可以使用路径版本。无论哪种方式,都应记录实际返回版本、监控各版本调用量,并安排旧版本的弃用日期。
上线前覆盖:缺少 Accept、*/*、同权重候选、未知语言、编码不匹配,以及代理缓存重复请求。把协商结果写入响应头和日志后,同一 URL 的不同响应就有了可解释、可回归的规则。