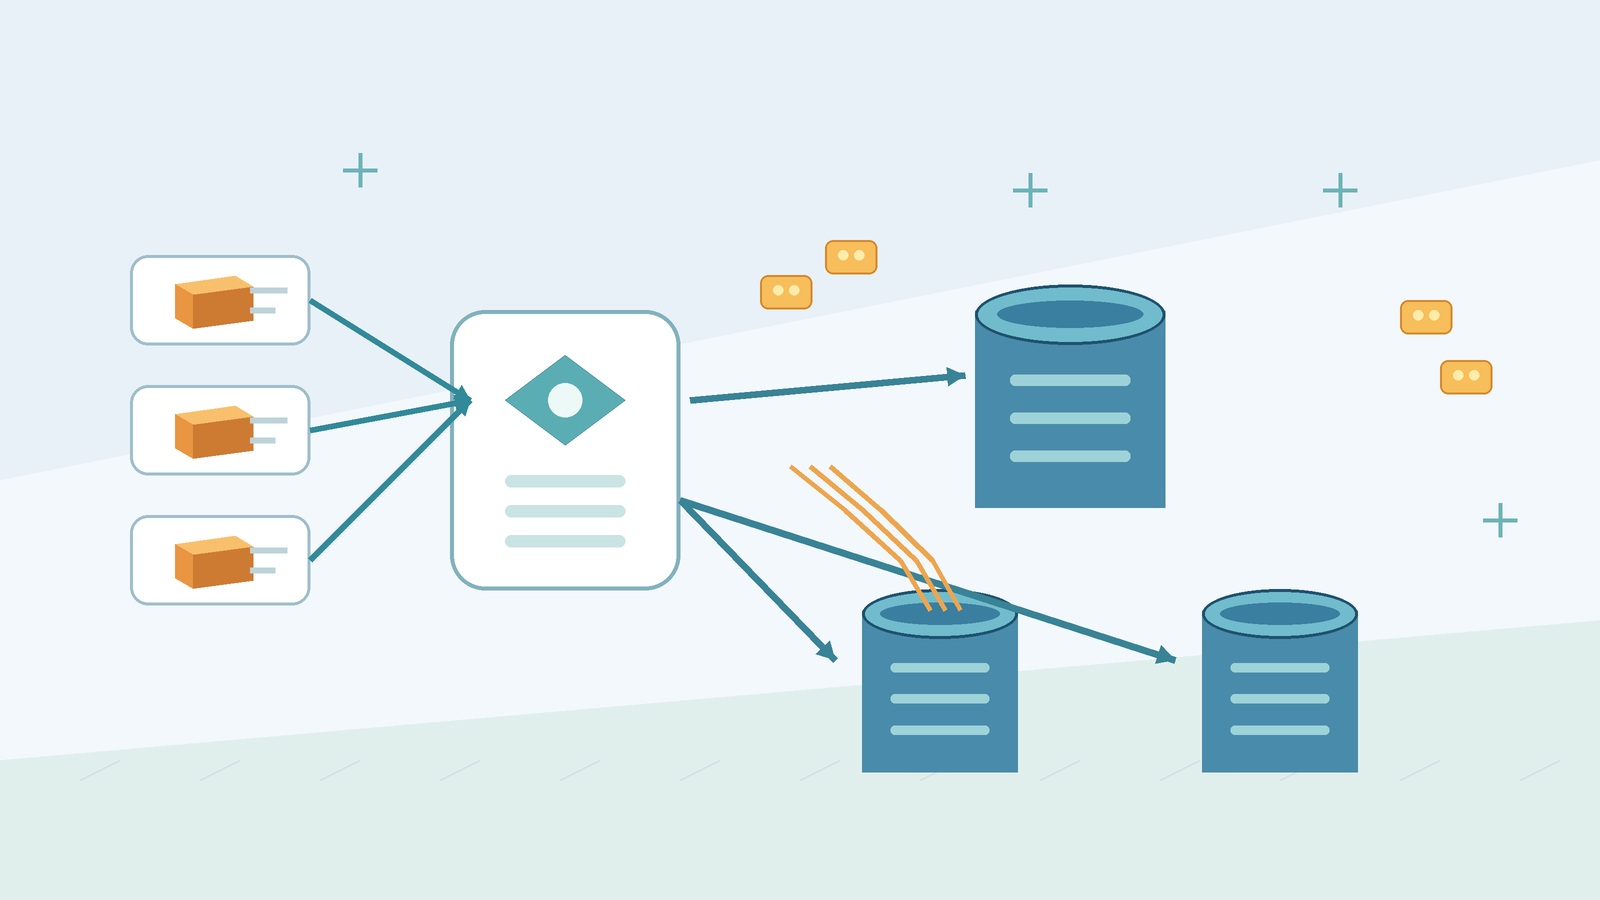
把查询分到只读副本,常常能缓解主库的 CPU 和连接压力,但它也引入了一个新的事实:写入完成,不代表每个副本已经看见这次写入。若路由只按“读走副本、写走主库”两条规则实现,用户就可能刚改完资料,刷新页面却看到旧值。读写分离的难点不是连上几个数据库,而是把复制延迟转换成可解释、可监控的业务策略。
先明确副本能提供什么
主库接收写入,副本通过复制日志异步追赶。副本扩展的是读取吞吐,通常不能承诺和主库同时可见。一次请求若先写主库,再从副本读取,就形成典型的“读后写不一致”。
| 业务场景 | 可接受的读取 | 推荐路由 |
|---|---|---|
| 商品搜索、排行榜 | 延迟几秒 | 健康副本 |
| 修改资料后的详情页 | 必须读到刚写内容 | 主库或确认追上的副本 |
| 扣款、库存校验 | 需要最新状态 | 主库事务 |
| 后台报表 | 可接受更长延迟 | 指定副本,限制并发 |
先给接口标注一致性等级,再决定路由;不要让底层连接池替业务做这个决定。
把复制延迟变成信号
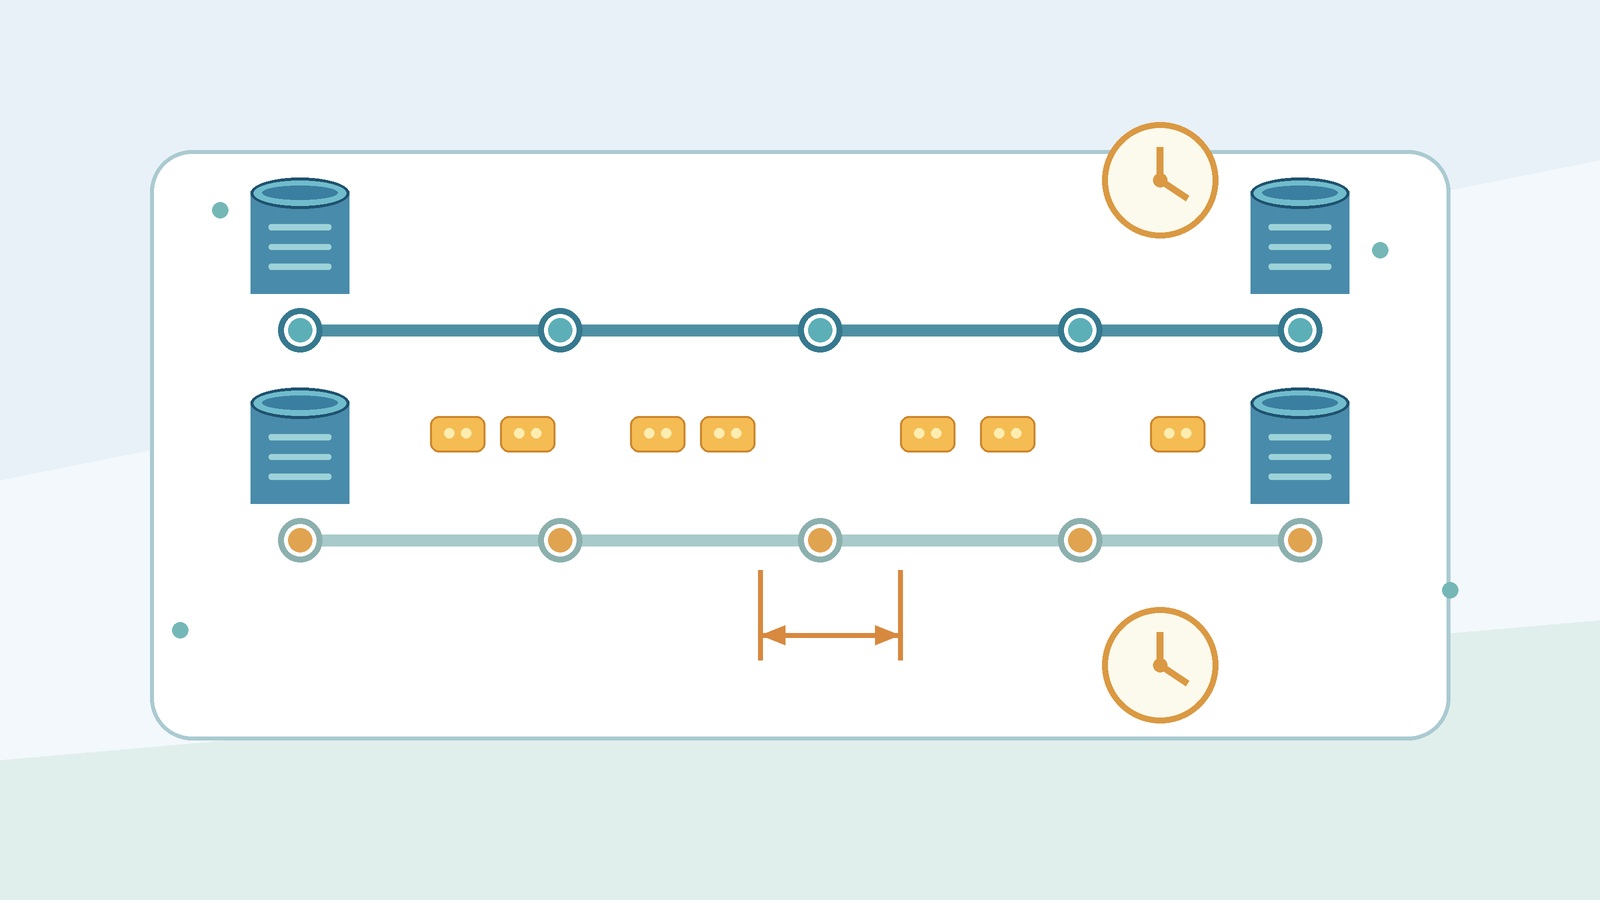
延迟不只是一条监控曲线。应用至少要能拿到副本的追赶位置或估算延迟,并设定“可读”阈值。若副本超过阈值,路由器应暂时摘除它,而不是继续把流量发过去。监控可以记录 replica_lag_seconds、复制错误、最老未追上的事务,以及请求回退主库的比例。只看平均值不够,长尾延迟更容易造成偶发旧数据。
用令牌保证读后写
一种通用做法是让写请求返回一个单调递增的写入令牌,后续读请求携带它。路由器选择已经追上该令牌的副本;没有合适副本时回退主库,保证正确性优先。
1 | async function readWithConsistency(req, query) { |
令牌可以由数据库位置、事务版本或应用层序列号表达,关键是比较规则稳定、跨请求可传递。若业务只要求同一会话内可见,也可以在写成功后把用户短暂粘到主库;粘滞时间要有上限,避免主库流量长期失去回落机会。
路由器还要处理故障
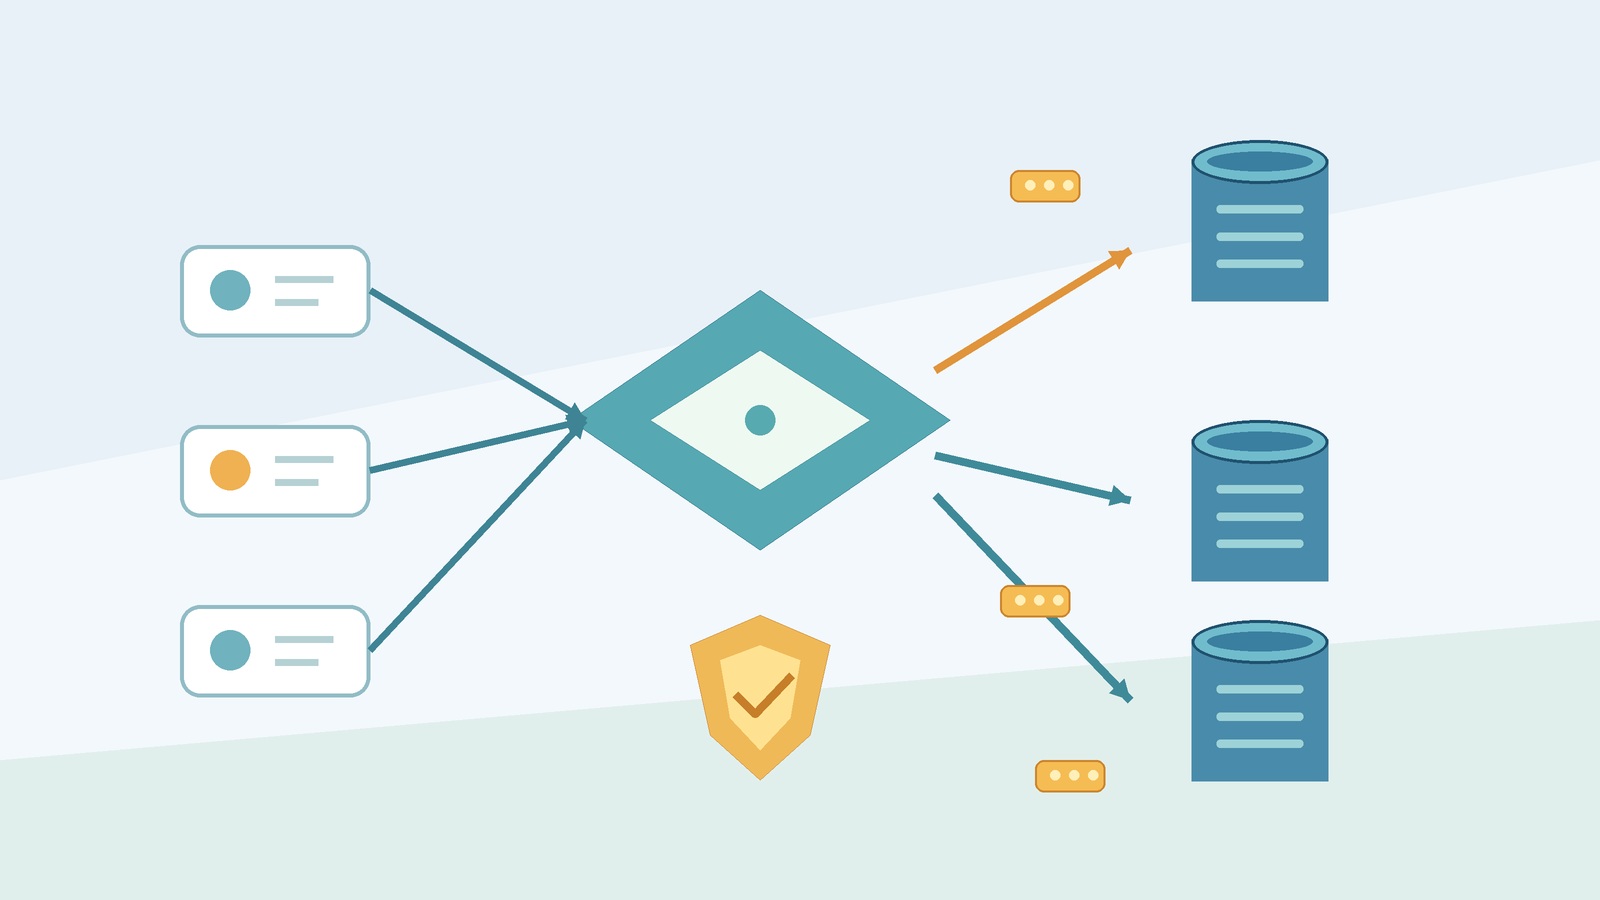
副本连接失败、复制中断或延迟超标时,应从候选池摘除并告警。读请求可以回退主库,但要设置并发上限,防止所有副本同时失效后主库被瞬间打满。回退次数、主库读比例和副本健康数量都应成为指标;否则“系统没报错”可能只是主库在默默承担全部查询。
读写分离也不能替代事务边界。需要多次读取保持一致的流程,应在同一事务或同一连接上完成;跨请求的页面展示则使用写入令牌或短暂粘滞。副本只读权限、独立连接池和查询超时也要单独配置,避免报表把在线请求挤出连接池。
上线前的验证清单
- 为每个读接口标注强一致、会话一致或最终一致。
- 记录副本延迟长尾、复制错误和回退主库比例。
- 注入延迟、断开副本,确认路由会摘除并恢复。
- 对主库回退设置并发上限和快速失败阈值。
- 分开统计主库写、主库读和副本读的连接池使用量。
- 压测“写后立即读”和副本全部变慢这两条路径。
读写分离的成功标准不是副本数量,而是每个请求都能说清楚“允许多旧的数据”和“达不到条件时怎么办”。把一致性等级、复制信号、路由回退和容量保护一起落地,副本才会成为可治理的扩展手段。